RESUMO
Hammer AI guia técnico: modelos, modos e privacidade
Hammer AI combina um cliente de desktop com modelos locais com serviços de chat e criativos alojados. Essa arquitetura dá aos utilizadores mais escolha do que uma interface apenas na nuvem, mas também torna rótulos amplos pouco fiáveis. Uma revisão útil tem de identificar a rota de modelo ativa, o caminho dos dados, o requisito de hardware e os termos comerciais atuais para cada fluxo de trabalho.
- Rota local
- Inferência de modelo no desktop
- Rota alojada
- Processamento de modelo na nuvem
- Principal restrição
- Memória mais tamanho do modelo
- Regra de revisão
- Verificar cada funcionalidade separadamente
Publicação independente. Controlos comerciais e imagens de evidência ligam a um serviço de terceiros separado.
RESPOSTA PRIMEIRO
O que é Hammer AI em termos técnicos?
Hammer AI é uma camada de aplicação para chat de personagens, histórias e fluxos de trabalho de media que pode chamar modelos de linguagem locais no desktop ou serviços alojados. A inferência local pode manter uma conversa no computador do utilizador e funcionar offline após a configuração; chat alojado, imagens, fala e sincronização podem usar infraestrutura da ou fornecedores terceiros. A política de privacidade atual é a fonte controladora para decisões de dados online, porque afirmações curtas na FAQ não descrevem todos os fornecedores ou caminhos de serviço gratuito.[1][2] Hammer AI
ÍNDICE DE PERSONAGENS
15 personagens originais observadas no catálogo público
Este índice visual amostra quinze perfis de Original Character públicos observados na Hammer AI. Regista apenas a variedade do catálogo: perfis, nomes e disponibilidade podem mudar após a data de observação.
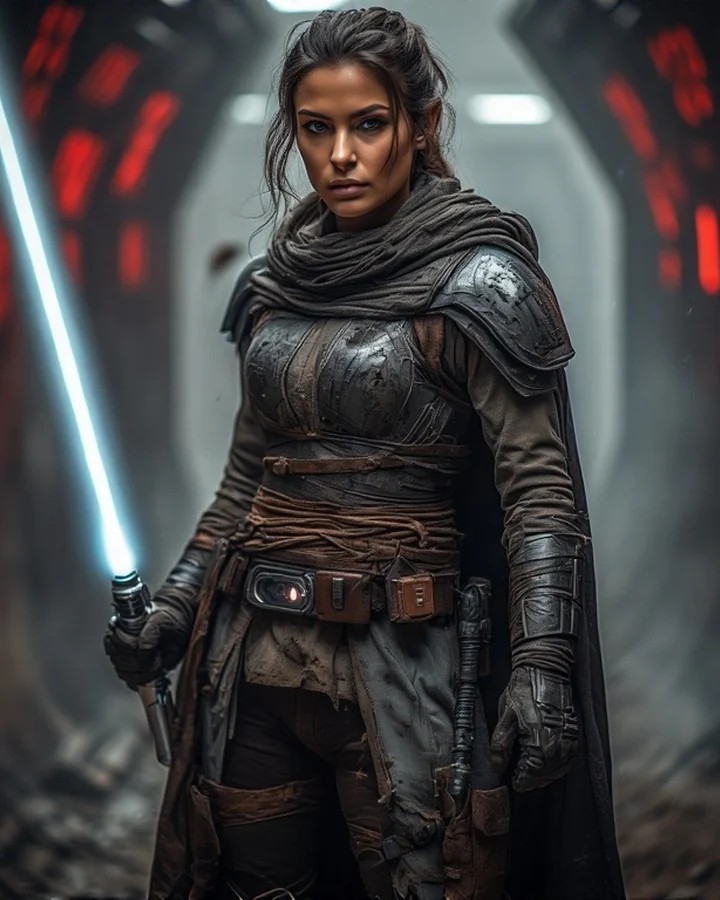
Taleia Vonn
Perfil de Original Character público observado em 19 de outubro de 2026.
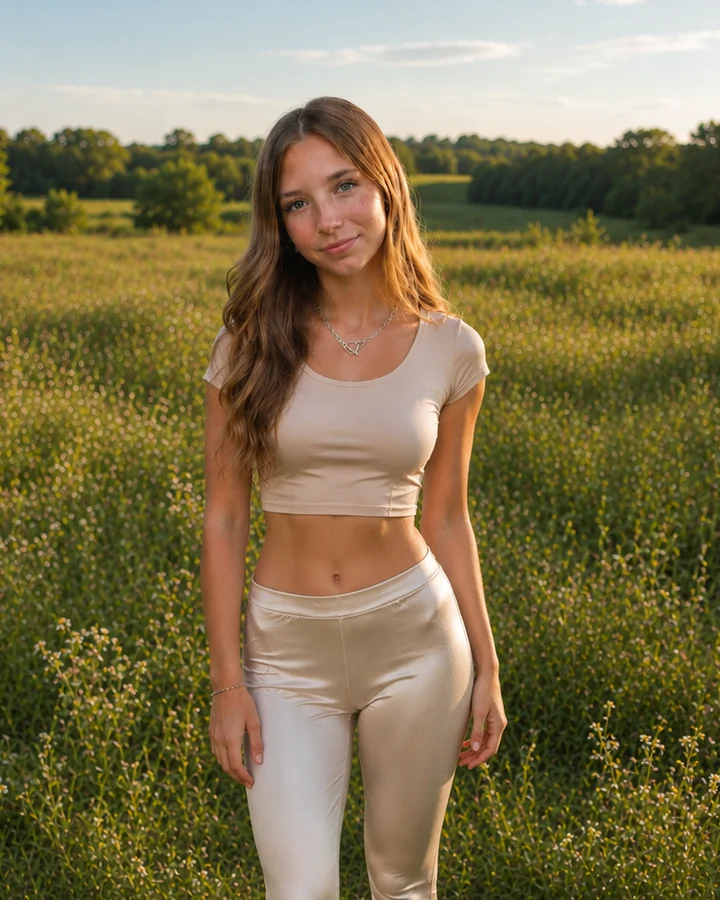
Kylie
Perfil de Original Character público observado em 19 de outubro de 2026.
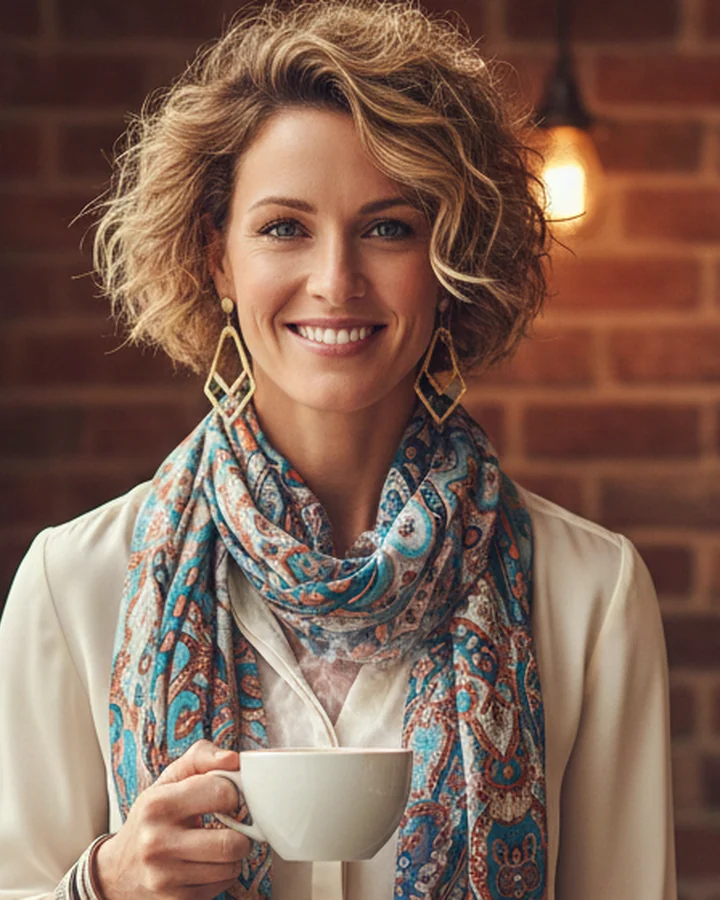
Victoria "Vicky" Hartley
Perfil de Original Character público observado em 19 de outubro de 2026.
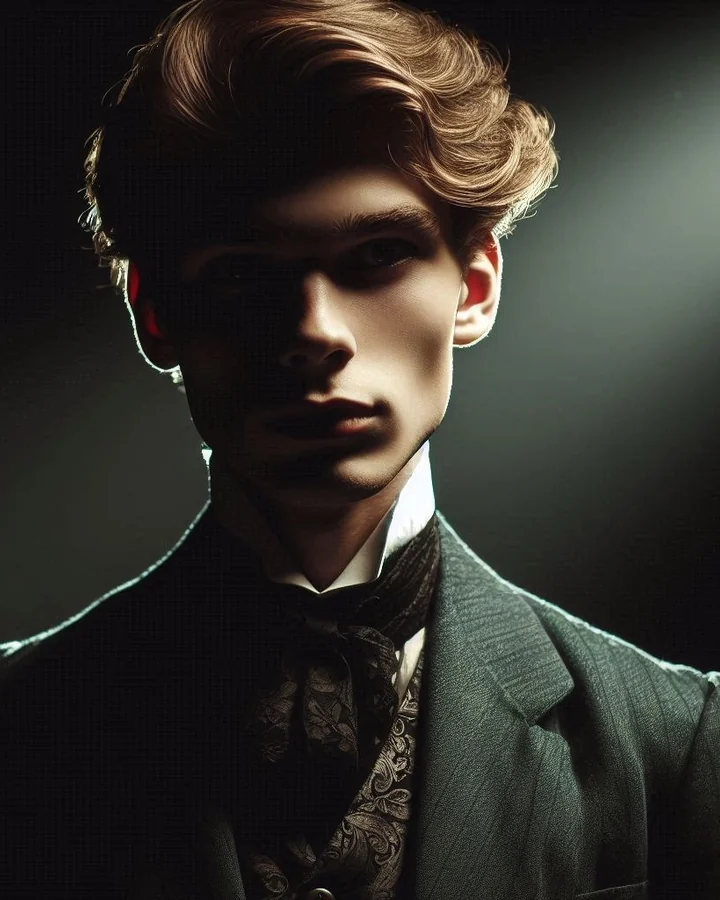
Cassius
Perfil de Original Character público observado em 19 de outubro de 2026.
Shanikua
Perfil de Original Character público observado em 19 de outubro de 2026.
The Dracolyr Crisis
Perfil de Original Character público observado em 19 de outubro de 2026.
Kyle
Perfil de Original Character público observado em 19 de outubro de 2026.
Akari Saito
Perfil de Original Character público observado em 19 de outubro de 2026.
Rowan
Perfil de Original Character público observado em 19 de outubro de 2026.
Aria, the Lighthouse Keeper
Perfil de Original Character público observado em 19 de outubro de 2026.
Sieglinde Seyfried
Perfil de Original Character público observado em 19 de outubro de 2026.
XERUS, CHAOS INCARNATE
Perfil de Original Character público observado em 19 de outubro de 2026.
Rosivelle
Perfil de Original Character público observado em 19 de outubro de 2026.
Ezekiel
Perfil de Original Character público observado em 19 de outubro de 2026.
Ruthanne
Perfil de Original Character público observado em 19 de outubro de 2026.
SELEÇÃO DE MODO
Qual rota da Hammer AI deve escolher?
A seleção de modelos começa com restrições, não com nomes de marcas. Decida se os dados podem sair do dispositivo, estime a memória disponível, escolha um alvo de velocidade aceitável e só depois compare ficheiros de modelo ou níveis alojados.
| Decisão | Rota local no desktop | Rota alojada |
|---|---|---|
| Caminho dos dados | A inferência pode permanecer no computador quando um modelo local é selecionado e verificado offline. | Entradas e saídas viajam para um serviço ou fornecedor de IA; regras de retenção do fornecedor podem aplicar-se.[1][2] |
| Hardware | O ficheiro do modelo deve caber na RAM ou VRAM com espaço adicional para contexto e aplicação.[3] | O serviço fornece computação, reduzindo requisitos locais mas adicionando dependência de rede. |
| Escolha do modelo | Ficheiros quantizados oferecem diferentes compromissos de tamanho e qualidade; configurações locais personalizadas podem ser possíveis. | O serviço controla o catálogo disponível, limites e calendário de descontinuação. |
| Uso offline | Possível após a aplicação e ficheiros de modelo estarem presentes; teste desconectando a rede.[1] | Não é um fluxo de trabalho offline. |
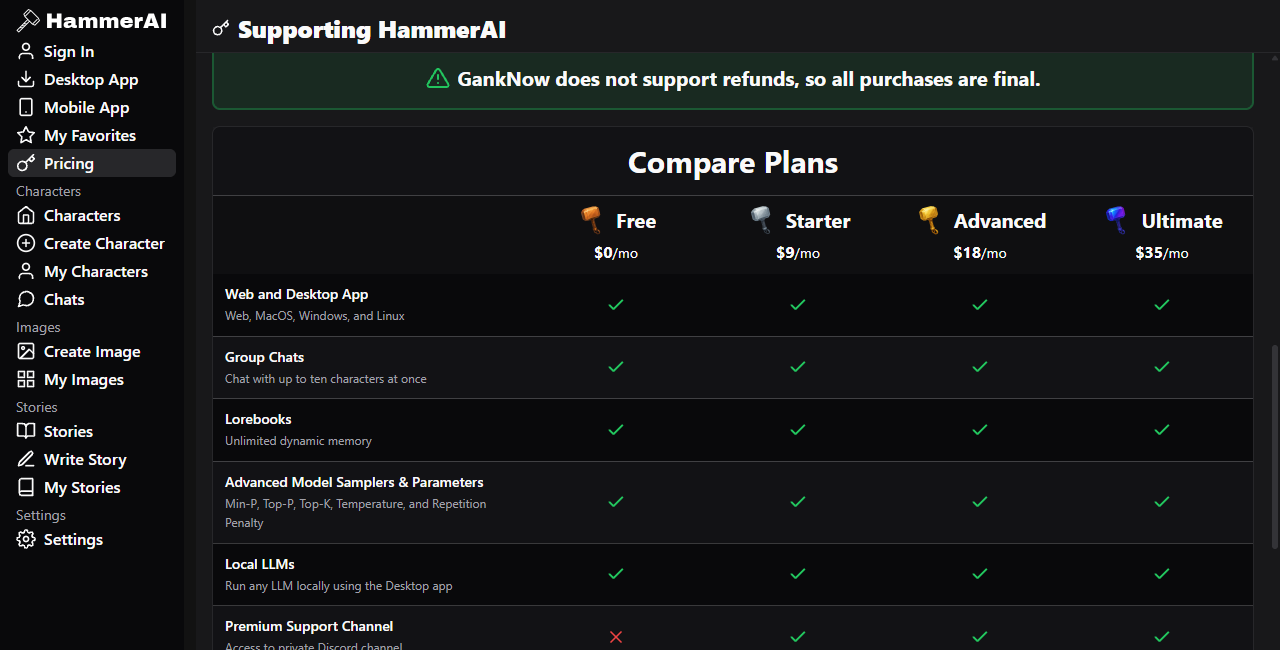
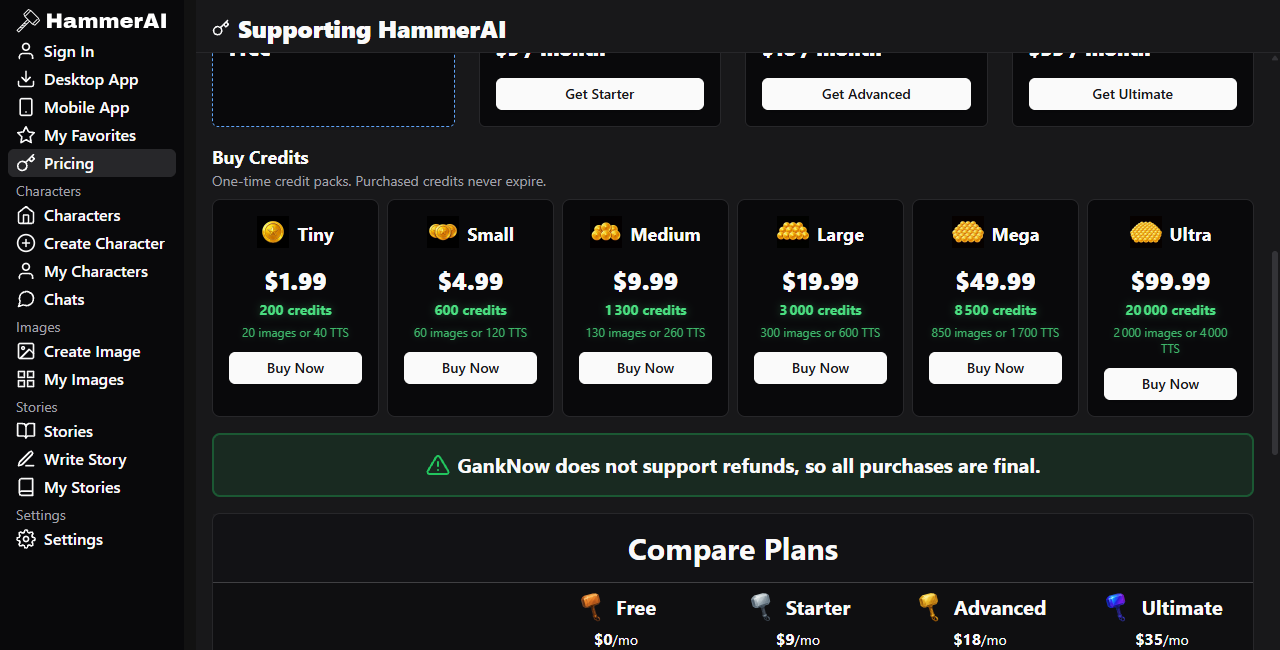
| Padrão de custo | O chat local é promovido como gratuito, mas hardware, armazenamento e eletricidade são custos do utilizador. | Subsídios gratuitos, subscrições e créditos únicos podem mudar na página de preços ao vivo.[4] |
| Melhor ajuste | Rascunhos privados, experimentação, testes reproduzíveis e utilizadores dispostos a gerir recursos locais. | Conveniência entre dispositivos, hardware local limitado e funcionalidades apenas oferecidas online. |
MÉTODO
Como foi montada esta revisão da Hammer AI?
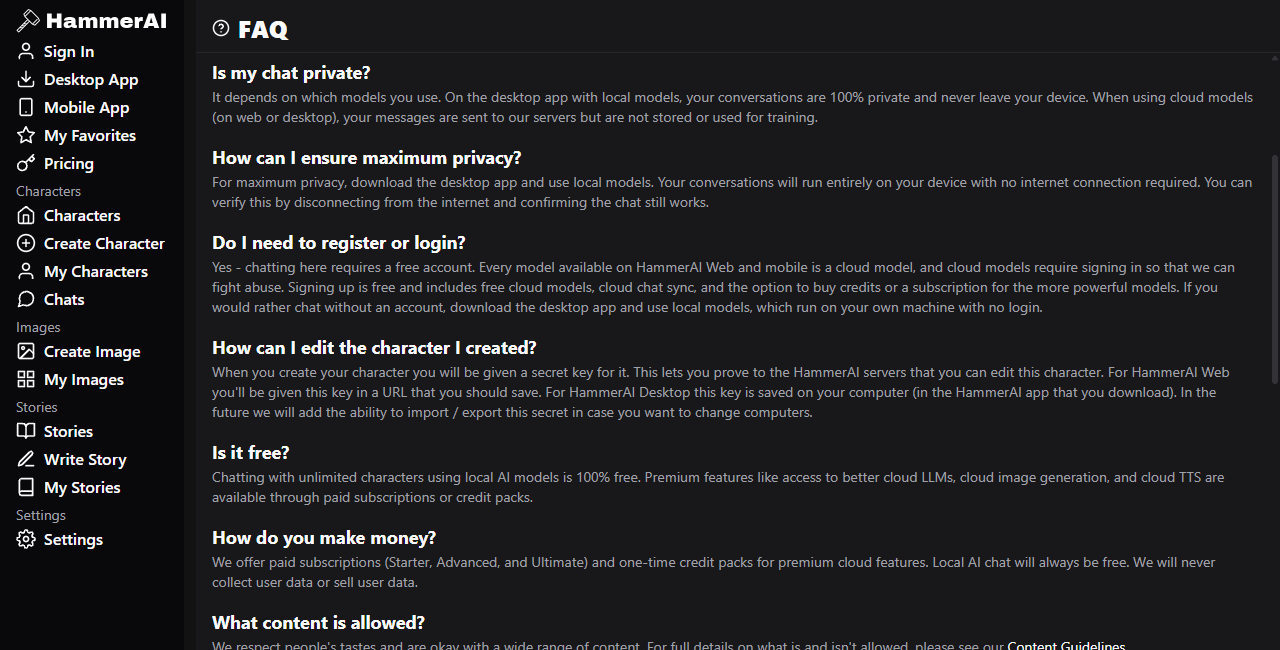
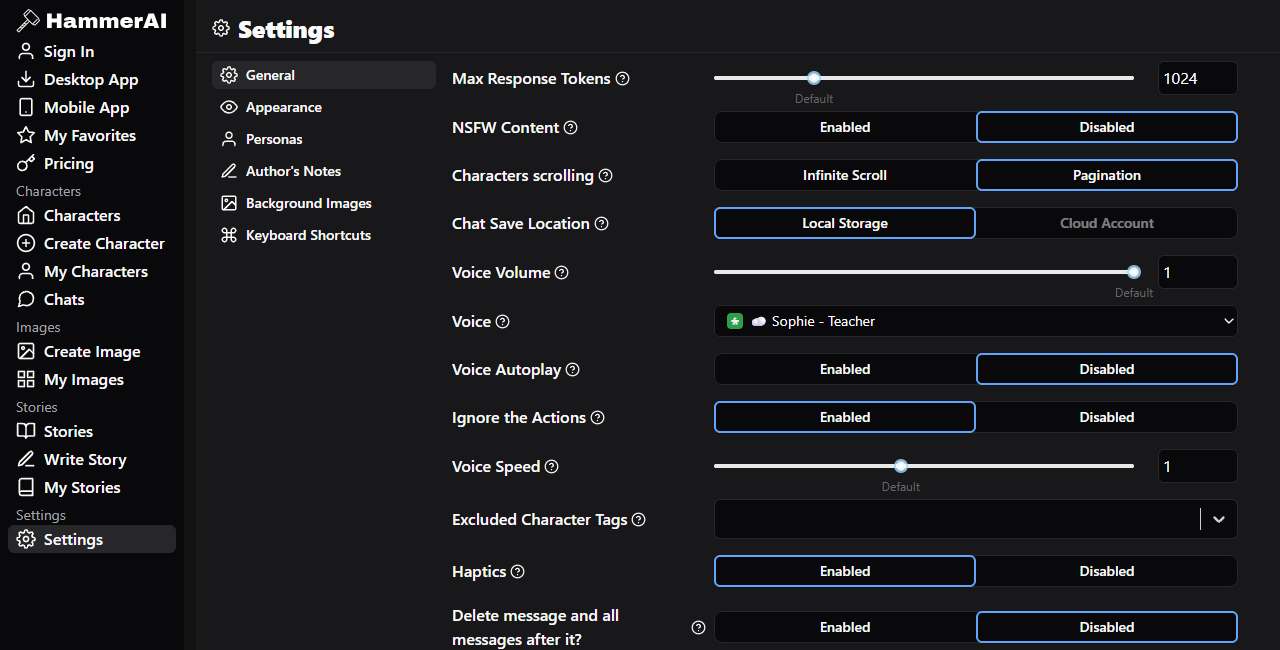
A revisão usa páginas oficiais públicas e capturas de navegador retidas datadas de 19 de outubro de 2026. Nenhum login, conversa privada, transação paga ou benchmark de modelo foi usado. As capturas de ecrã documentam controlos e redação visíveis, não comportamento de backend. Onde as páginas oficiais conflituam, este guia nomeia o conflito e favorece a política de privacidade mais detalhada sobre um resumo de marketing ou FAQ mais curto.
Isto importa porque a FAQ pública diz que mensagens alojadas não são armazenadas nem usadas para treino, enquanto a política de privacidade diz que fornecedores de IA terceiros podem reter entradas e saídas e podem usá-las sob as suas próprias políticas. A política também descreve publicidade contextual para alguns serviços online gratuitos. Essas afirmações não podem ser comprimidas com segurança em “a nuvem é privada”.[1][2]
MAPA DO SISTEMA
Como está a Hammer AI dividida entre sistemas locais, alojados e criativos?
Inferência local no desktop
Um modelo local selecionado corre no hardware do utilizador. A FAQ pública descreve um teste de verificação offline e diz que uma rota local pode operar sem conta.[1]
- Requer downloads de aplicação e modelo.
- O desempenho segue limites de RAM, VRAM, CPU ou GPU.
- A saída local ainda pode ser imprecisa ou insegura.
Modelos de linguagem alojados
Pedidos alojados usam computação remota. A política de privacidade diz que fornecedores de IA externos podem receber prompts e saídas, e os seus termos de retenção ou treino podem aplicar-se.[2]
- Requer ligação à rede.
- Catálogo e limites de contexto são controlados pelo serviço.
- Regras de conta ou plano podem mudar.
Camada de serviço criativo
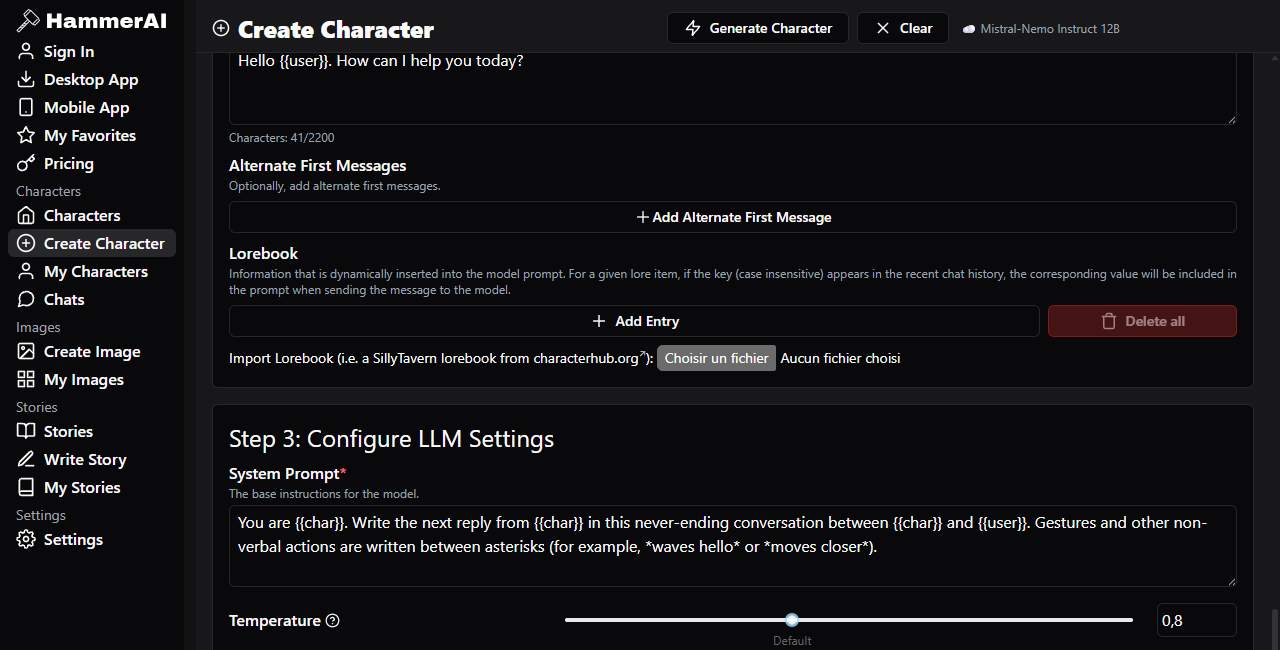
Definições de personagens, lorebooks, ferramentas de história, geração de imagens, fala e controlos de preferência rodeiam a rota do modelo. Cada parte pode ter o seu próprio armazenamento, fornecedor e regras de crédito.
- Campos de prompt influenciam comportamento, não verdade.
- Imagens e fala devem ser avaliadas como serviços online.
- Sincronização é um caminho de dados separado.
PROCEDIMENTO
Como deve dimensionar e testar um modelo local da Hammer AI?
Inventariar a máquina
Registe memória do sistema, memória gráfica dedicada, espaço livre em disco e sistema operativo. Não escolha um modelo apenas pelo número de parâmetros ou nome.
Escolher um ficheiro conservador
O guia oficial de quantização descreve variantes de modelo comprimidas e recomenda deixar memória para contexto e outro software. Ficheiros mais pequenos carregam mais facilmente; compressão agressiva pode reduzir qualidade.[3]
Estabelecer um conjunto de prompts
Use alguns prompts repetíveis cobrindo seguimento de instruções, diálogo, contexto longo e comportamento de recusa. Um conjunto fixo torna comparações de modelo mais úteis do que uma única resposta impressionante.
Medir o gargalo real
Observe tempo de carregamento, tempo até ao primeiro token, velocidade de resposta contínua e pressão de memória. Um modelo que cabe no disco mas troca memória constantemente não é uma escolha prática.
Verificar o caminho dos dados
Desligue a rede e repita um prompt inofensivo. Se o chat parar, uma dependência alojada ainda está ativa. Se continuar, registe o modelo selecionado e a configuração para que o teste seja reproduzível.[1]
PLACAS DE EVIDÊNCIA
O que provam realmente as capturas de ecrã retidas da Hammer AI?
Cada placa suporta uma observação estreita sobre a interface visível. Nenhuma prova qualidade de modelo, comportamento de servidor ou disponibilidade atual após a data de captura.
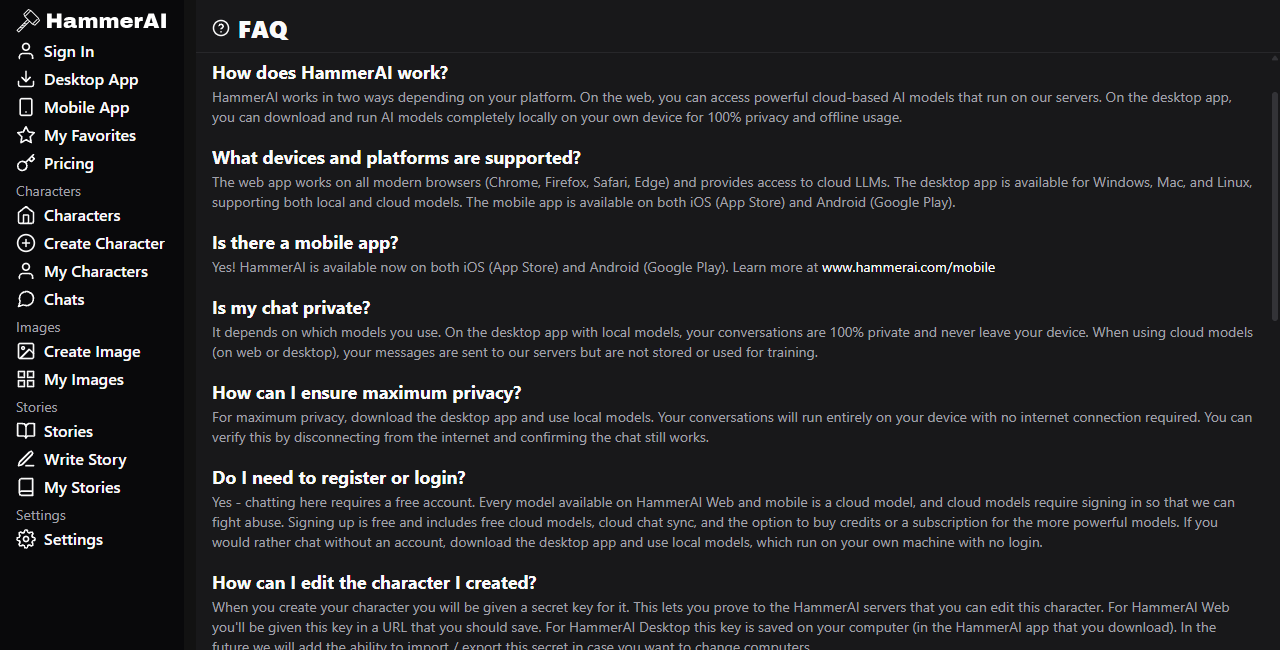
MATRIZ DE PÚBLICO
Quem beneficia da Hammer AI, e o que pode correr mal?
Espaço de trabalho de rascunho privado
Bom ajuste: escritores que podem verificar inferência local e querem uma ferramenta de brainstorming offline. Modo de falha: deixar exportações sensíveis, backups ou registos desprotegidos na mesma máquina.
Prototipagem de sistema de personagens
Bom ajuste: criadores a testar estrutura de persona, cenário, exemplos e lore. Modo de falha: tratar mais campos de prompt como garantia de comportamento consistente.
Comparação de modelos locais
Bom ajuste: utilizadores a comparar tamanhos de ficheiro, quantizações e definições de amostragem. Modo de falha: mudar vários controlos ao mesmo tempo e tirar conclusões de um único prompt.
Conveniência alojada
Bom ajuste: utilizadores com hardware limitado ou necessidades entre dispositivos. Modo de falha: confiar numa frase curta de privacidade da FAQ sem ler divulgações de fornecedor e publicidade.[1][2]
Idea de imagem e voz
Bom ajuste: experiências criativas de baixo risco após verificar créditos atuais. Modo de falha: carregar material privado, protegido por direitos de autor ou identificável sem entender a rota online.
Suporte a decisões profissionais
Ajuste pobre: decisões médicas, legais, financeiras, de segurança ou emergência. Confiança gerada não é evidência, e execução local não melhora responsabilidade factual.
LEITURA DE PRIVACIDADE
Como deve interpretar as alegações de privacidade da Hammer AI?
Use uma interpretação em camadas. Primeiro, um modelo local no desktop verificado pode manter inferência no computador e continuar sem ligação à rede. Segundo, o produto mais amplo ainda tem contas, diagnósticos, subscrições, infraestrutura e serviços online. Terceiro, a política de privacidade diz que fornecedores de IA externos podem processar e reter prompts e saídas alojados, enquanto alguns serviços web ou móveis gratuitos podem enviar conteúdo recente para publicidade contextual. A afirmação defensável é que a Hammer AI oferece uma rota local, não que cada funcionalidade da é offline ou sem fornecedor.[1][2] Hammer AI
Para trabalho sensível, registe o cliente exato, modelo selecionado, estado de início de sessão, estado de rede e funcionalidade ativada. Evite imagens na nuvem, fala ou sincronização a menos que a sua política atual seja aceitável. Armazenamento no dispositivo e inferência local são propriedades diferentes e devem ser testadas separadamente.
VEREDITO
Quando faz sentido técnico usar Hammer AI?
Hammer AI faz sentido quando um utilizador quer uma interface para chat de modelo local e fluxos de trabalho de personagens estruturados sem construir um front-end personalizado. O seu valor é integração prática: seleção de modelo, prompts de personagem, lore, histórias, ferramentas de media e preferências num só produto. O custo dessa amplitude é ambiguidade. A fronteira de privacidade muda por modo, a experiência local muda com hardware, e catálogos ou subsídios online podem mudar sem tornar uma captura antiga falsa.
Escolha-o para experiências que pode verificar e saídas que vai rever. Não o escolha assumindo que cada funcionalidade é local, que um modelo maior é sempre melhor, ou que detalhes de plano publicados permanecerão fixos. Os Termos oficiais restringem uso a adultos e colocam responsabilidade por uso legal e conteúdo gerado no utilizador.[5]
Explorar um serviço de personagens de IAFAQ
Que perguntas técnicas deve fazer antes de usar Hammer AI?
Pode a Hammer AI funcionar totalmente offline?
O chat local no desktop pode funcionar offline após instalação e download do modelo. Modelos alojados, sincronização, geração de imagens e fala devem ser assumidos como precisando de ligação a menos que a interface atual prove explicitamente o contrário.[1]
Quanta memória um modelo precisa?
O ficheiro do modelo deve caber na RAM ou VRAM disponível com espaço extra para contexto e aplicação. Quantização reduz requisitos de ficheiro e memória, mas compressão mais forte pode reduzir qualidade de saída.[3]
Um modelo local torna a saída fiável?
Não. Local descreve onde a inferência acontece, não se a resposta é precisa, imparcial ou segura. Aplique os mesmos padrões de verificação a saída local e alojada.
Podem os fornecedores da Hammer AI treinar em chats na nuvem?
A política de privacidade diz que fornecedores de IA terceiros podem reter entradas e saídas e podem usá-las para melhorar ou treinar os seus modelos sob as suas próprias políticas. Verifique os termos do fornecedor nomeado mostrados no serviço atual.[2]
Os preços capturados ainda são válidos?
Não necessariamente. As capturas retidas provam o que a página mostrava quando capturada. A página de preços ao vivo é a fonte para subscrições atuais, créditos, limites de contexto e acesso a modelos.[4]
A Hammer AI é destinada a menores?
Não. Os Termos oficiais dizem que os utilizadores devem ter pelo menos 18 anos ou a idade de consentimento na sua jurisdição, a que for maior.[5]
FONTES
Que fontes oficiais suportam este guia de campo?
- [1] FAQ da Hammer AI — descrições de rota, teste offline e declarações de conta.
- [2] Política de privacidade da Hammer AI — fornecedores alojados, publicidade contextual, contas e diagnósticos.
- [3] Guia de modelos e quantizações da Hammer AI — memória, tamanho de ficheiro e compromissos de compressão.
- [4] Página de preços da Hammer AI — planos atuais, subsídios e apresentação de créditos.
- [5] Termos da Hammer AI — elegibilidade adulta, responsabilidade do utilizador e condições de serviço.
Data de observação: 19 de outubro de 2026. Ecrãs de produto, catálogos de modelos, linguagem de privacidade e limites comerciais podem mudar. Páginas oficiais atuais têm precedência sobre capturas retidas.