RESUMEN
Hammer AI guía técnica: modelos, modos y privacidad
Hammer AI combina un cliente de escritorio con modelos locales con servicios alojados de chat y creativos. Esa arquitectura da a los usuarios más opciones que una interfaz solo en la nube, pero también hace que las etiquetas amplias no sean fiables. Una reseña útil debe identificar la ruta de modelo activa, la ruta de datos, el requisito de hardware y las condiciones comerciales actuales para cada flujo de trabajo.
- Ruta local
- Inferencia de modelo de escritorio
- Ruta alojada
- Procesamiento de modelo en la nube
- Restricción principal
- Memoria más tamaño del modelo
- Regla de revisión
- Verificar cada función por separado
Publicación independiente. Los controles comerciales y las imágenes de evidencia enlazan a un servicio de terceros separado.
RESPUESTA PRIMERO
¿Qué es Hammer AI en términos técnicos?
Hammer AI es una capa de aplicación para chat de personajes, historias y flujos de medios que puede llamar a modelos de lenguaje locales de escritorio o a servicios alojados. La inferencia local puede mantener una conversación en el ordenador del usuario y funcionar sin conexión después de la configuración; el chat alojado, las imágenes, el habla y la sincronización pueden usar la infraestructura de o proveedores de terceros. La política de privacidad actual es la fuente que controla las decisiones de datos en línea porque las afirmaciones más cortas de la FAQ no describen cada proveedor o ruta de servicio gratuito.[1][2] Hammer AI
ÍNDICE DE PERSONAJES
15 personajes originales observados en el catálogo público
Este índice visual muestra quince perfiles públicos de personajes originales observados en Hammer AI. Solo registra la variedad del catálogo: los perfiles, nombres y disponibilidad pueden cambiar después de la fecha de observación.
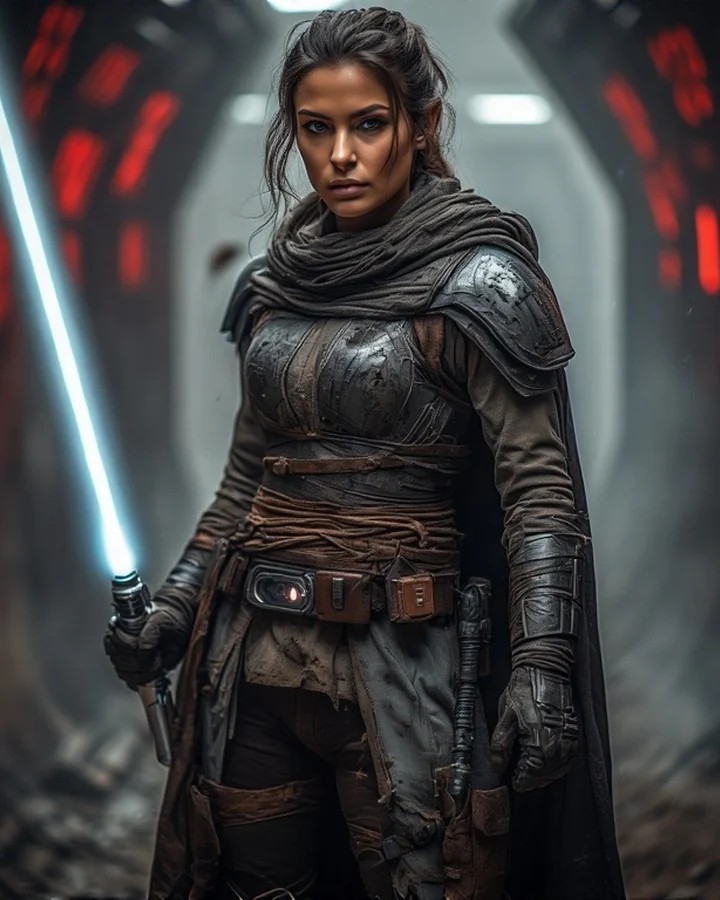
Taleia Vonn
Perfil público de personaje original observado el 19 de octubre de 2026.
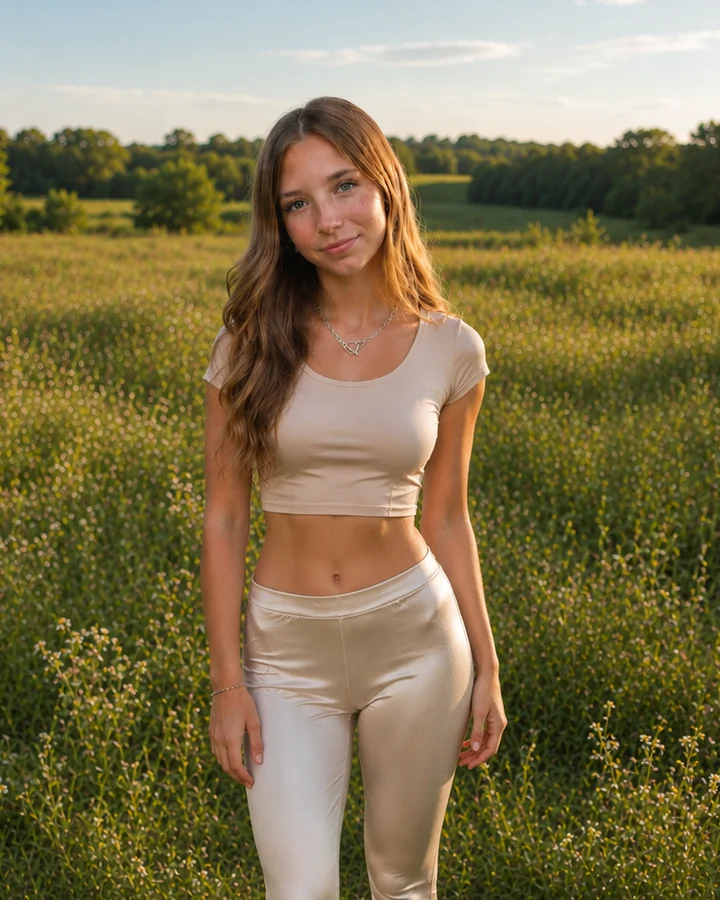
Kylie
Perfil público de personaje original observado el 19 de octubre de 2026.
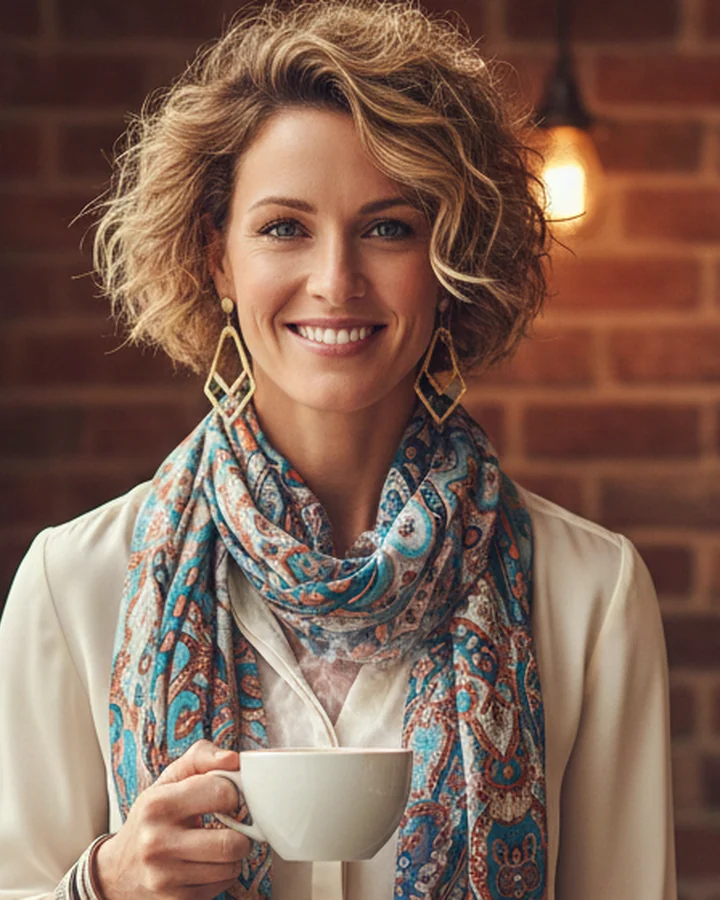
Victoria "Vicky" Hartley
Perfil público de personaje original observado el 19 de octubre de 2026.
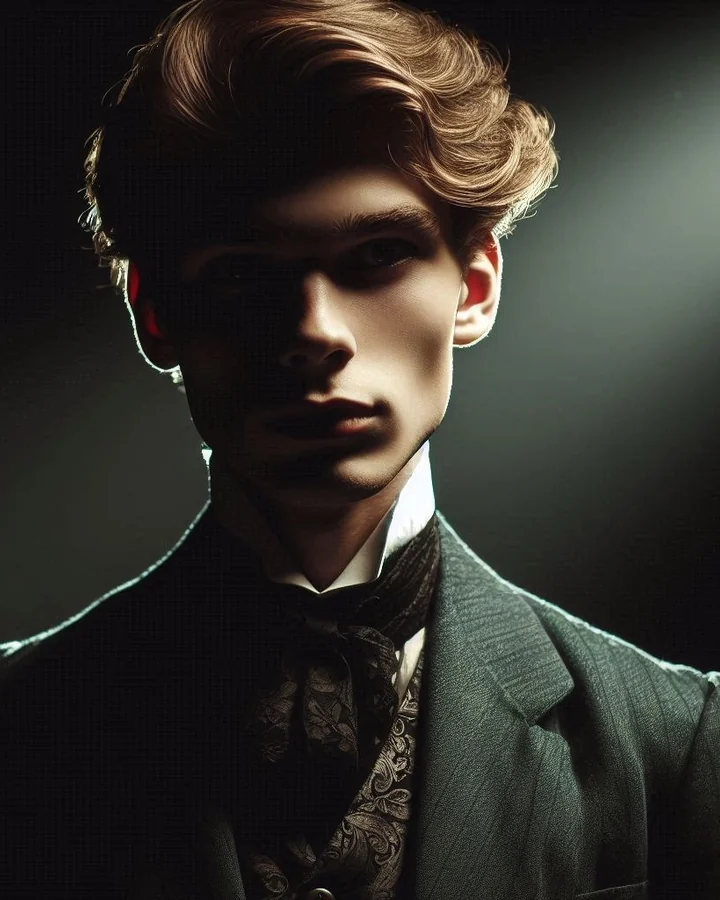
Cassius
Perfil público de personaje original observado el 19 de octubre de 2026.
Shanikua
Perfil público de personaje original observado el 19 de octubre de 2026.
The Dracolyr Crisis
Perfil público de personaje original observado el 19 de octubre de 2026.
Kyle
Perfil público de personaje original observado el 19 de octubre de 2026.
Akari Saito
Perfil público de personaje original observado el 19 de octubre de 2026.
Rowan
Perfil público de personaje original observado el 19 de octubre de 2026.
Aria, the Lighthouse Keeper
Perfil público de personaje original observado el 19 de octubre de 2026.
Sieglinde Seyfried
Perfil público de personaje original observado el 19 de octubre de 2026.
XERUS, CHAOS INCARNATE
Perfil público de personaje original observado el 19 de octubre de 2026.
Rosivelle
Perfil público de personaje original observado el 19 de octubre de 2026.
Ezekiel
Perfil público de personaje original observado el 19 de octubre de 2026.
Ruthanne
Perfil público de personaje original observado el 19 de octubre de 2026.
SELECCIÓN DE MODO
¿Qué ruta de Hammer AI deberías elegir?
La selección de modelos comienza con restricciones, no con nombres de marca. Decide si los datos pueden salir del dispositivo, estima la memoria disponible, elige un objetivo de velocidad aceptable y solo entonces compara archivos de modelo o niveles alojados.
| Decisión | Ruta local de escritorio | Ruta alojada |
|---|---|---|
| Ruta de datos | La inferencia puede permanecer en el ordenador cuando se selecciona un modelo local y se verifica sin conexión. | Las entradas y salidas viajan a un servicio o proveedor de IA; pueden aplicarse reglas de retención del proveedor.[1][2] |
| Hardware | El archivo del modelo debe caber en RAM o VRAM con espacio adicional para el contexto y la aplicación.[3] | El servicio proporciona cómputo, reduciendo los requisitos locales pero añadiendo dependencia de red. |
| Elección de modelo | Los archivos cuantizados ofrecen diferentes compensaciones de tamaño y calidad; pueden ser posibles configuraciones locales personalizadas. | El servicio controla el catálogo disponible, los límites y el calendario de retirada. |
| Uso sin conexión | Posible después de que la aplicación y los archivos del modelo estén presentes; prueba desconectando la red.[1] | No es un flujo de trabajo sin conexión. |
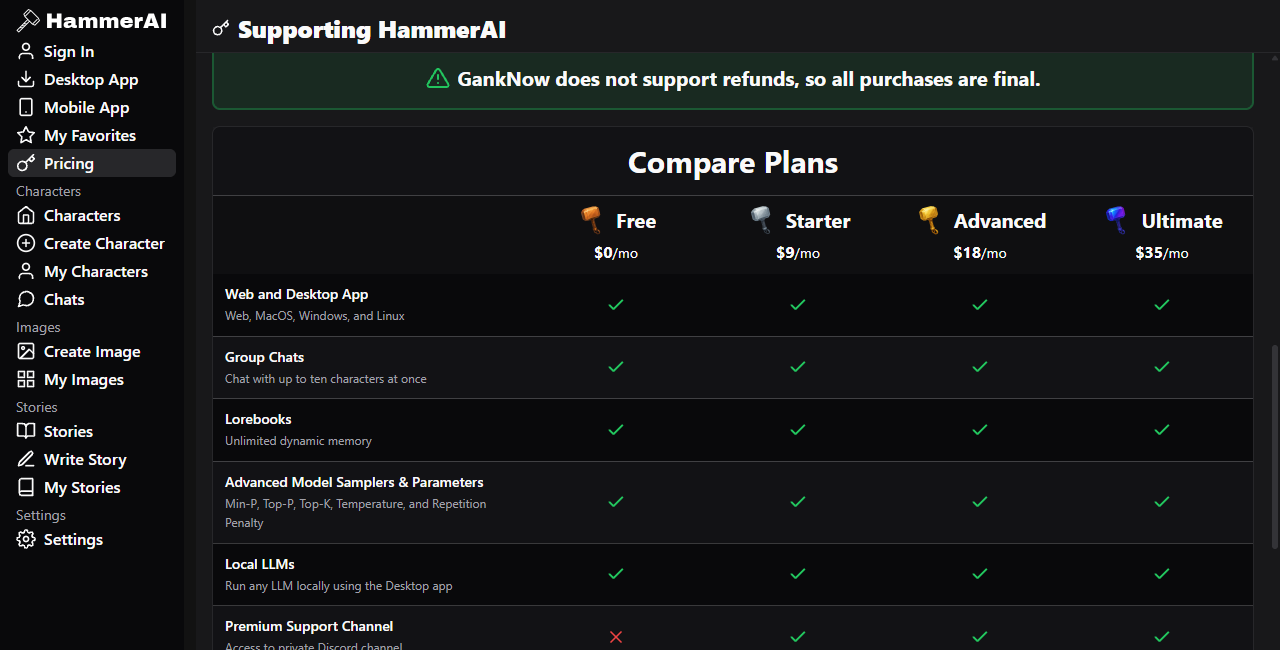
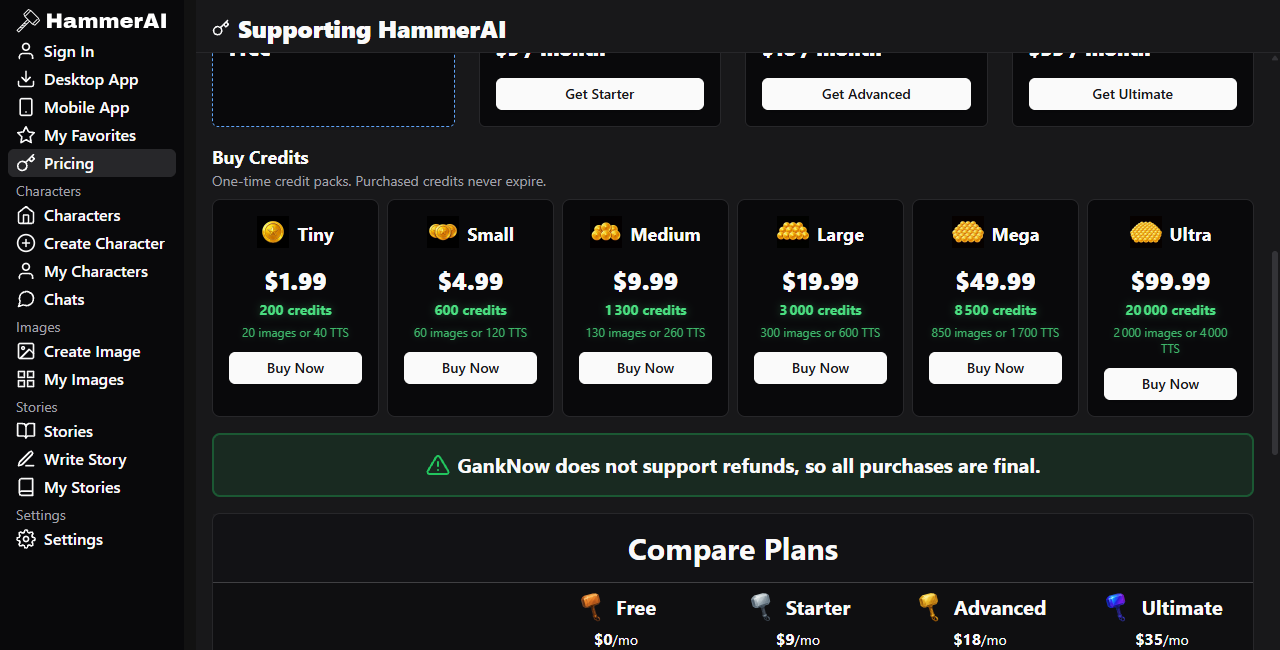
| Patrón de coste | El chat local se promociona como gratuito, pero el hardware, el almacenamiento y la electricidad son costes del usuario. | Los permisos gratuitos, las suscripciones y los créditos únicos pueden cambiar en la página de precios en vivo.[4] |
| Mejor ajuste | Borradores privados, experimentación, pruebas reproducibles y usuarios dispuestos a gestionar recursos locales. | Comodidad entre dispositivos, hardware local limitado y funciones que solo se ofrecen en línea. |
MÉTODO
¿Cómo se ensambló esta reseña de Hammer AI?
La reseña utiliza páginas oficiales públicas y capturas de navegador retenidas con fecha del 19 de octubre de 2026. No se usó inicio de sesión, conversación privada, transacción de pago ni benchmark de modelo. Las capturas documentan controles y redacción visibles, no el comportamiento del backend. Cuando las páginas oficiales entran en conflicto, esta guía nombra el conflicto y favorece la política de privacidad más detallada sobre un resumen de marketing o FAQ más corto.
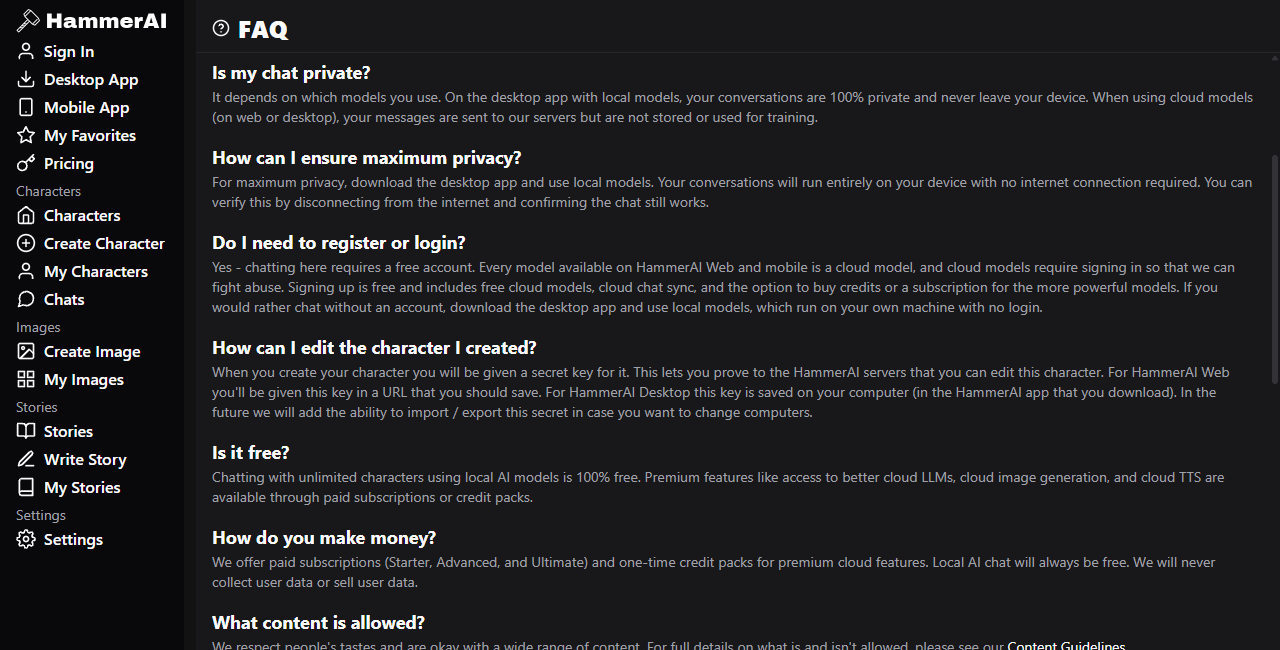
Esto importa porque la FAQ pública dice que los mensajes alojados no se almacenan ni se usan para entrenamiento, mientras que la política de privacidad dice que los proveedores de IA de terceros pueden retener entradas y salidas y pueden usarlas bajo sus propias políticas. La política también describe publicidad contextual para algunos servicios gratuitos en línea. Esas declaraciones no pueden comprimirse de forma segura en “la nube es privada”.[1][2]
MAPA DEL SISTEMA
¿Cómo se divide Hammer AI entre sistemas locales, alojados y creativos?
Inferencia local de escritorio
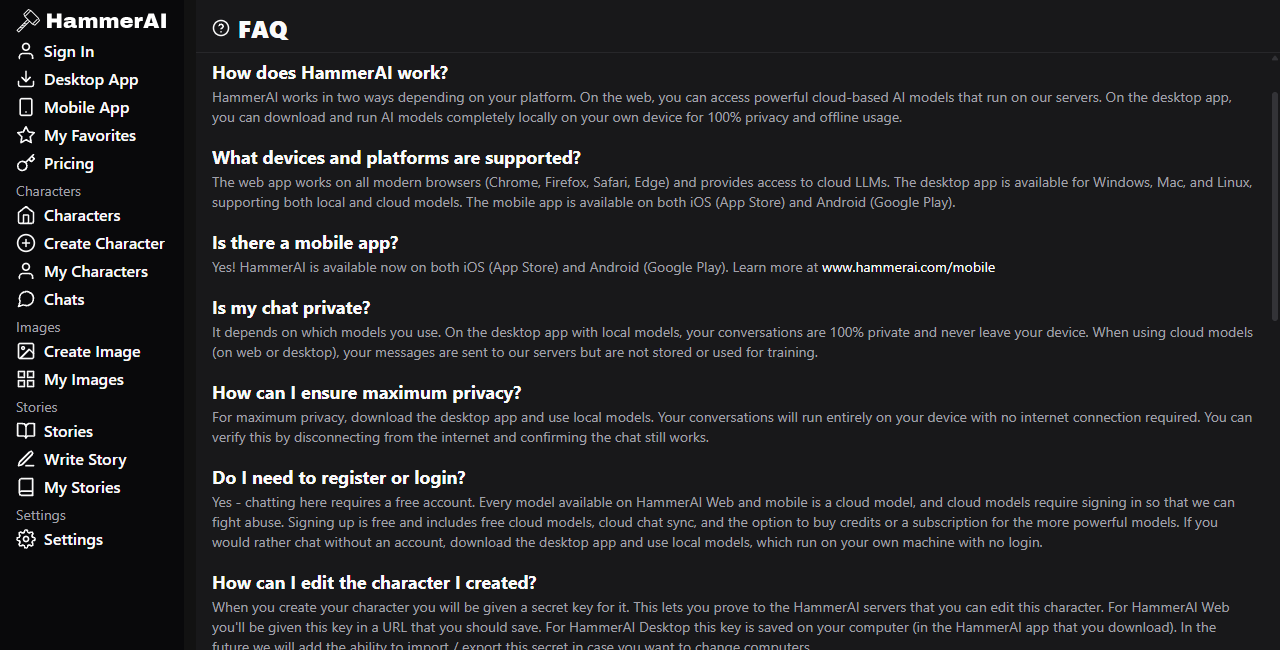
Un modelo local seleccionado se ejecuta en el hardware del usuario. La FAQ pública describe una prueba de verificación sin conexión y dice que una ruta local puede operar sin cuenta.[1]
- Requiere descargas de aplicación y modelo.
- El rendimiento sigue los límites de RAM, VRAM, CPU o GPU.
- La salida local aún puede ser inexacta o insegura.
Modelos de lenguaje alojados
Las solicitudes alojadas usan cómputo remoto. La política de privacidad dice que los proveedores de IA externos pueden recibir prompts y salidas, y sus términos de retención o entrenamiento pueden aplicarse.[2]
- Requiere conexión de red.
- El catálogo y los límites de contexto están controlados por el servicio.
- Las reglas de cuenta o plan pueden cambiar.
Capa de servicios creativos
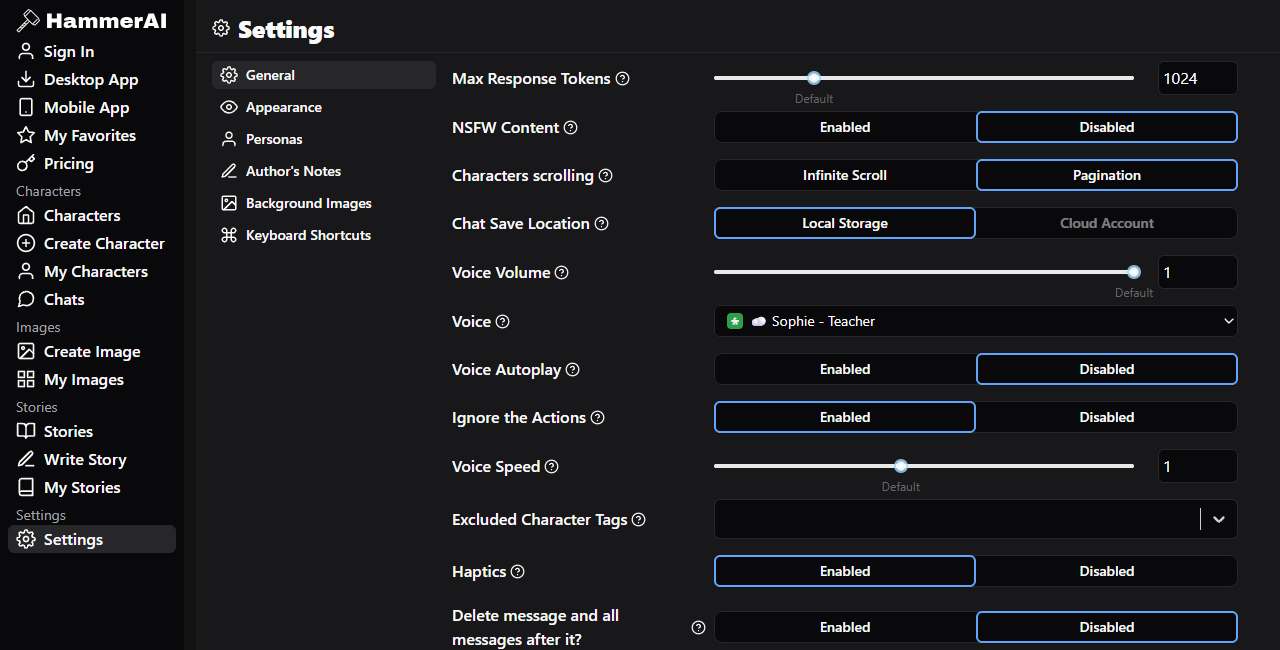
Las definiciones de personajes, lorebooks, herramientas de historias, generación de imágenes, habla y controles de preferencia rodean la ruta del modelo. Cada parte puede tener su propio almacenamiento, proveedor y reglas de crédito.
- Los campos de prompt influyen en el comportamiento, no en la verdad.
- Las imágenes y el habla deben evaluarse como servicios en línea.
- La sincronización es una ruta de datos separada.
PROCEDIMIENTO
¿Cómo deberías dimensionar y probar un modelo local de Hammer AI?
Inventaría la máquina
Registra la memoria del sistema, la memoria gráfica dedicada, el espacio libre en disco y el sistema operativo. No elijas un modelo solo por su número de parámetros o nombre.
Elige un archivo conservador
La guía oficial de cuantización describe variantes de modelo comprimidas y recomienda dejar memoria para el contexto y otro software. Los archivos más pequeños cargan más fácilmente; la compresión agresiva puede reducir la calidad.[3]
Establece un conjunto de prompts
Usa algunos prompts repetibles que cubran seguimiento de instrucciones, diálogo, contexto largo y comportamiento de rechazo. Un conjunto fijo hace que las comparaciones de modelos sean más útiles que una sola respuesta impresionante.
Mide el cuello de botella real
Observa el tiempo de carga, el tiempo hasta el primer token, la velocidad de respuesta continua y la presión de memoria. Un modelo que cabe en disco pero intercambia memoria constantemente no es una opción práctica.
Verifica la ruta de datos
Desconecta la red y repite un prompt inofensivo. Si el chat se detiene, una dependencia alojada sigue activa. Si continúa, registra el modelo y la configuración seleccionados para que la prueba sea reproducible.[1]
PLACAS DE EVIDENCIA
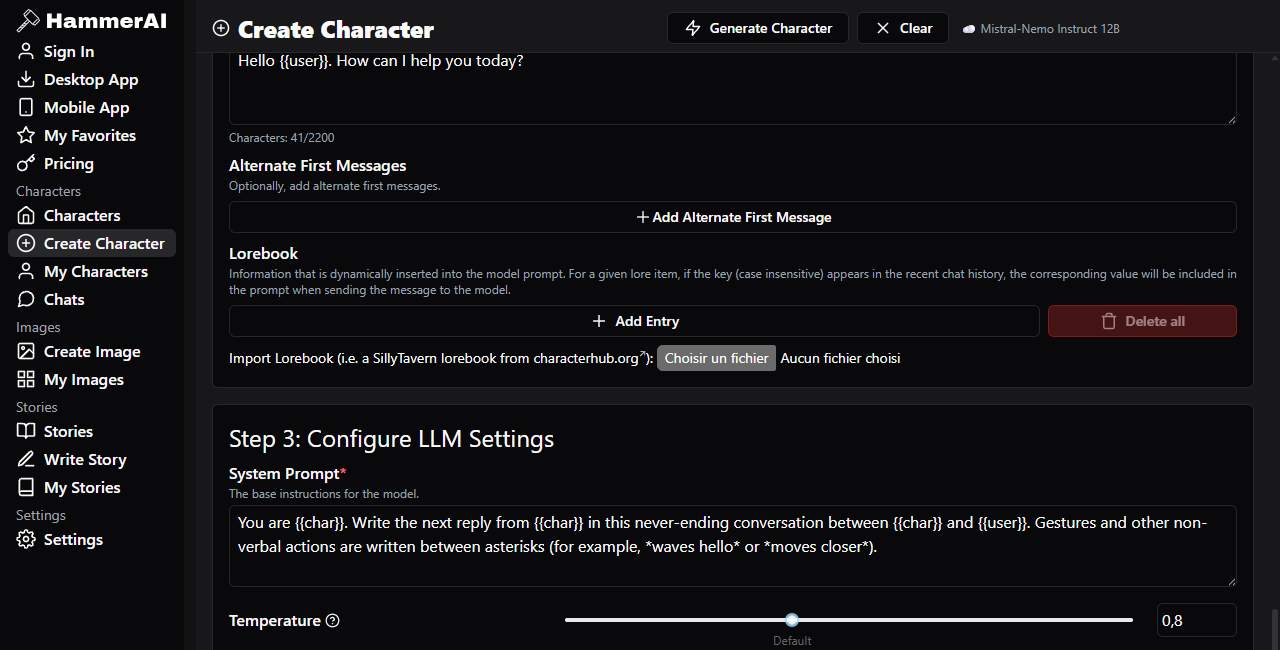
¿Qué prueban realmente las capturas retenidas de Hammer AI?
Cada placa respalda una observación estrecha sobre la interfaz visible. Ninguna prueba la calidad del modelo, el comportamiento del servidor o la disponibilidad actual después de la fecha de captura.
MATRIZ DE AUDIENCIA
¿Quién se beneficia de Hammer AI, y qué puede salir mal?
Espacio de trabajo de borradores privados
Buena adecuación: escritores que pueden verificar la inferencia local y quieren una herramienta de lluvia de ideas sin conexión. Modo de fallo: dejar exportaciones sensibles, copias de seguridad o registros sin proteger en la misma máquina.
Prototipado de sistemas de personajes
Buena adecuación: creadores que prueban estructura de persona, escenario, ejemplos y lore. Modo de fallo: tratar más campos de prompt como garantía de comportamiento consistente.
Comparación de modelos locales
Buena adecuación: usuarios que comparan tamaños de archivo, cuantizaciones y ajustes de muestreo. Modo de fallo: cambiar varios controles a la vez y sacar conclusiones de un solo prompt.
Comodidad alojada
Buena adecuación: usuarios con hardware limitado o necesidades entre dispositivos. Modo de fallo: confiar en una frase corta de privacidad de la FAQ sin leer las divulgaciones del proveedor y de publicidad.[1][2]
Ideación de imágenes y voz
Buena adecuación: experimentos creativos de bajo riesgo después de verificar los créditos actuales. Modo de fallo: subir material privado, con derechos de autor o identificable sin entender la ruta en línea.
Soporte de decisiones profesional
Mala adecuación: decisiones médicas, legales, financieras, de seguridad o de emergencia. La confianza generada no es evidencia, y la ejecución local no mejora la responsabilidad factual.
LECTURA DE PRIVACIDAD
¿Cómo deberías interpretar las afirmaciones de privacidad de Hammer AI?
Usa una interpretación en capas. Primero, un modelo local de escritorio verificado puede mantener la inferencia en el ordenador y continuar sin conexión de red. Segundo, el producto más amplio aún tiene cuentas, diagnósticos, suscripciones, infraestructura y servicios en línea. Tercero, la política de privacidad dice que los proveedores de IA externos pueden procesar y retener prompts y salidas alojados, mientras que algunos servicios web o móviles gratuitos pueden enviar contenido reciente para publicidad contextual. La declaración defendible es que Hammer AI ofrece una ruta local, no que cada función de sea sin conexión o sin proveedor.[1][2] Hammer AI
Para trabajo sensible, registra el cliente exacto, el modelo seleccionado, el estado de inicio de sesión, el estado de red y la función habilitada. Evita imágenes en la nube, habla o sincronización a menos que su política actual sea aceptable. El almacenamiento del dispositivo y la inferencia local son propiedades diferentes y deben probarse por separado.
VEREDICTO
¿Cuándo tiene sentido técnico Hammer AI?
Hammer AI tiene sentido cuando un usuario quiere una interfaz para chat de modelos locales y flujos de trabajo estructurados de personajes sin construir un front-end personalizado. Su valor es la integración práctica: selección de modelos, prompts de personajes, lore, historias, herramientas de medios y preferencias en un solo producto. El coste de esa amplitud es la ambigüedad. El límite de privacidad cambia según el modo, la experiencia local cambia con el hardware, y los catálogos o permisos en línea pueden cambiar sin hacer que una captura antigua sea falsa.
Elígelo para experimentos que puedas verificar y salidas que revisarás. No lo elijas asumiendo que cada función es local, que un modelo más grande siempre es mejor, o que los detalles del plan publicado permanecerán fijos. Los Términos oficiales restringen el uso a adultos y colocan la responsabilidad por el uso legal y el contenido generado en el usuario.[5]
Explorar un servicio de personajes de IAFAQ
¿Qué preguntas técnicas deberías hacer antes de usar Hammer AI?
¿Puede Hammer AI funcionar completamente sin conexión?
El chat local de escritorio puede funcionar sin conexión después de la instalación y la descarga del modelo. Los modelos alojados, la sincronización, la generación de imágenes y el habla deben asumirse que necesitan conexión a menos que la interfaz actual lo pruebe explícitamente.[1]
¿Cuánta memoria necesita un modelo?
El archivo del modelo debe caber en RAM o VRAM disponible con espacio extra para el contexto y la aplicación. La cuantización reduce los requisitos de archivo y memoria, pero una compresión más fuerte puede reducir la calidad de salida.[3]
¿Un modelo local hace que la salida sea confiable?
No. Local describe dónde ocurre la inferencia, no si la respuesta es precisa, imparcial o segura. Aplica los mismos estándares de verificación a la salida local y alojada.
¿Pueden los proveedores de Hammer AI entrenar con chats en la nube?
La política de privacidad dice que los proveedores de IA de terceros pueden retener entradas y salidas y pueden usarlas para mejorar o entrenar sus modelos bajo sus propias políticas. Verifica los términos del proveedor nombrado que se muestran en el servicio actual.[2]
¿Los precios capturados siguen siendo válidos?
No necesariamente. Las capturas retenidas prueban lo que la página mostró cuando se capturó. La página de precios en vivo es la fuente para suscripciones, créditos, límites de contexto y acceso a modelos actuales.[4]
¿Está Hammer AI destinado a menores?
No. Los Términos oficiales dicen que los usuarios deben tener al menos 18 años o la edad de consentimiento en su jurisdicción, lo que sea mayor.[5]
FUENTES
¿Qué fuentes oficiales respaldan esta guía de campo?
- [1] Preguntas frecuentes de Hammer AI — descripciones de ruta, prueba sin conexión y declaraciones de cuenta.
- [2] Política de privacidad de Hammer AI — proveedores alojados, publicidad contextual, cuentas y diagnósticos.
- [3] Guía de modelos y cuantizaciones de Hammer AI — memoria, tamaño de archivo y compensaciones de compresión.
- [4] Página de precios de Hammer AI — planes actuales, permisos y presentación de créditos.
- [5] Términos de Hammer AI — elegibilidad de adultos, responsabilidad del usuario y condiciones del servicio.
Fecha de observación: 19 de octubre de 2026. Las pantallas del producto, los catálogos de modelos, el lenguaje de privacidad y los límites comerciales pueden cambiar. Las páginas oficiales actuales tienen prioridad sobre las capturas retenidas.