STRESZCZENIE
Hammer AI przewodnik techniczny: modele, tryby i prywatność
Hammer AI łączy klienta desktopowego z modelami lokalnymi z hostowanymi usługami czatu i kreatywnymi. Ta architektura daje użytkownikom więcej wyboru niż interfejs tylko chmurowy, ale też sprawia, że ogólne etykiety są niewiarygodne. Przydatna recenzja musi określić aktywną trasę modelu, ścieżkę danych, wymagania sprzętowe i aktualne warunki komercyjne dla każdego przepływu pracy.
- Trasa lokalna
- Inferencja modelu na komputerze
- Trasa hostowana
- Przetwarzanie modelu w chmurze
- Główne ograniczenie
- Pamięć plus rozmiar modelu
- Zasada recenzji
- Weryfikuj każdą funkcję osobno
Niezależna publikacja. Kontrole komercyjne i obrazy dowodowe prowadzą do osobnej usługi zewnętrznej.
ODPOWIEDŹ NAJPIERW
Czym jest Hammer AI w ujęciu technicznym?
Hammer AI to warstwa aplikacyjna dla czatu z postaciami, opowieści i przepływów medialnych, która może korzystać z lokalnych modeli językowych na komputerze lub usług hostowanych. Lokalna inferencja może utrzymać rozmowę na komputerze użytkownika i działać offline po konfiguracji; hostowany czat, obrazy, mowa i synchronizacja mogą korzystać z infrastruktury lub zewnętrznych dostawców. Aktualna polityka prywatności jest źródłem nadrzędnym dla decyzji o danych online, ponieważ krótsze stwierdzenia w FAQ nie opisują każdego dostawcy ani ścieżki darmowej.[1][2] Hammer AI
INDEKS POSTACI
15 oryginalnych postaci zaobserwowanych w publicznym katalogu
Ten wizualny indeks prezentuje piętnaście publicznych profili Oryginalnych Postaci zaobserwowanych na Hammer AI. Odnotowuje tylko różnorodność katalogu: profile, nazwy i dostępność mogą się zmienić po dacie obserwacji.
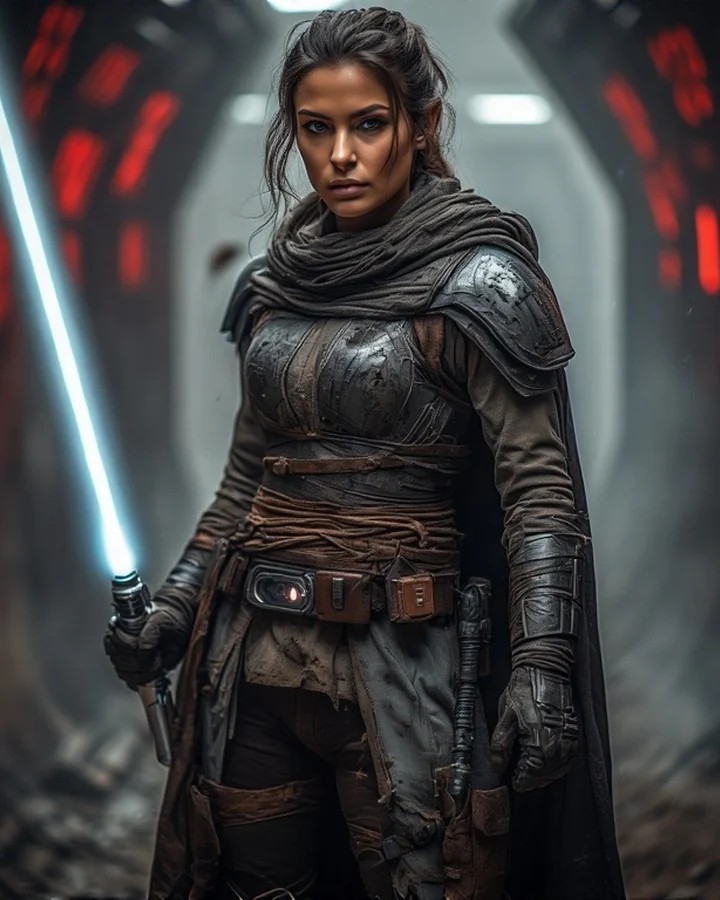
Taleia Vonn
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
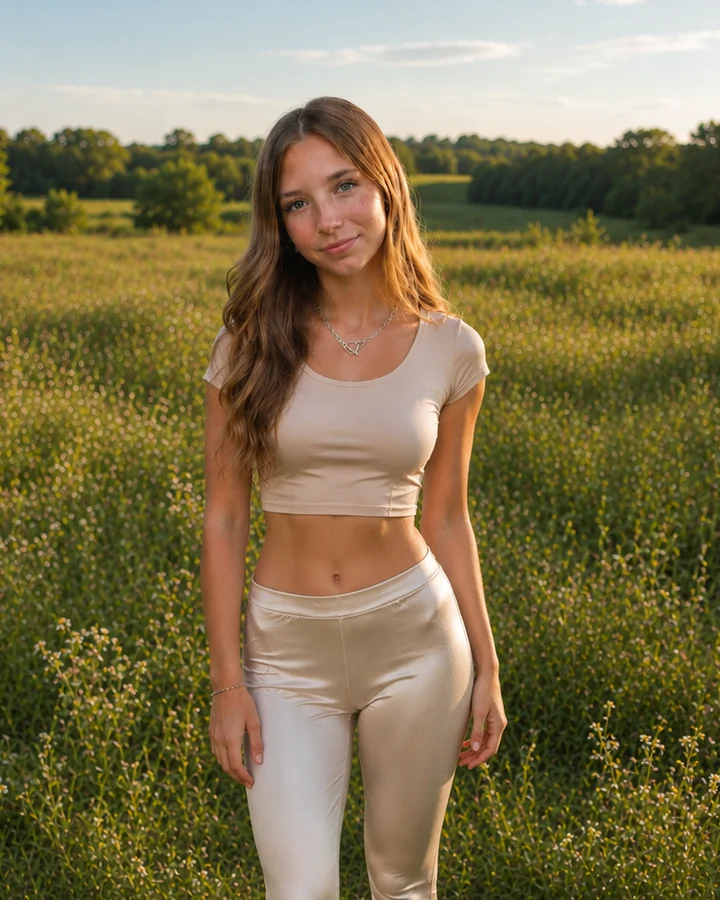
Kylie
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
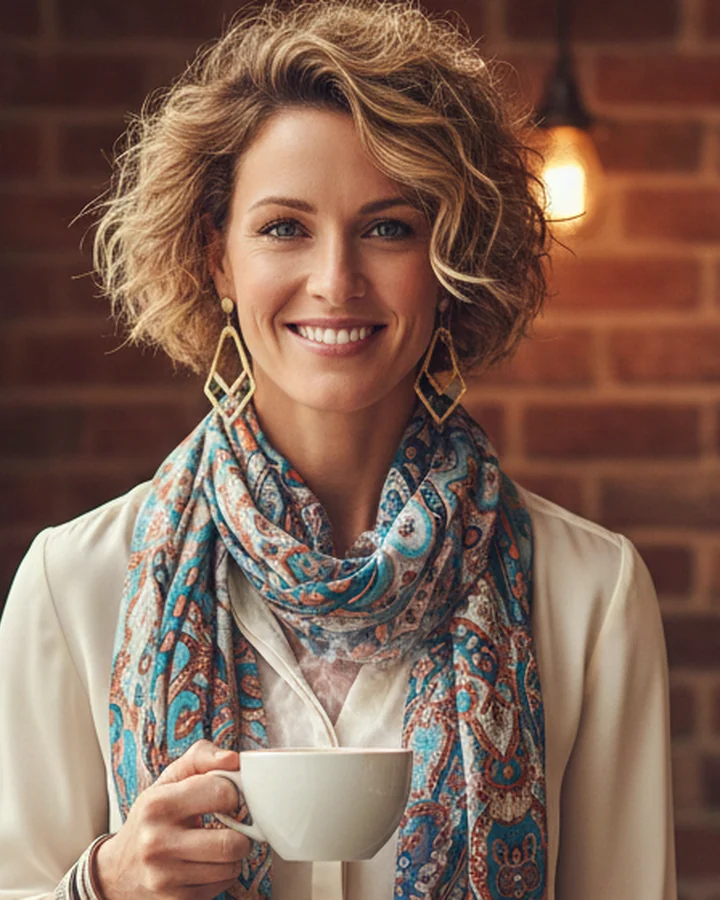
Victoria "Vicky" Hartley
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
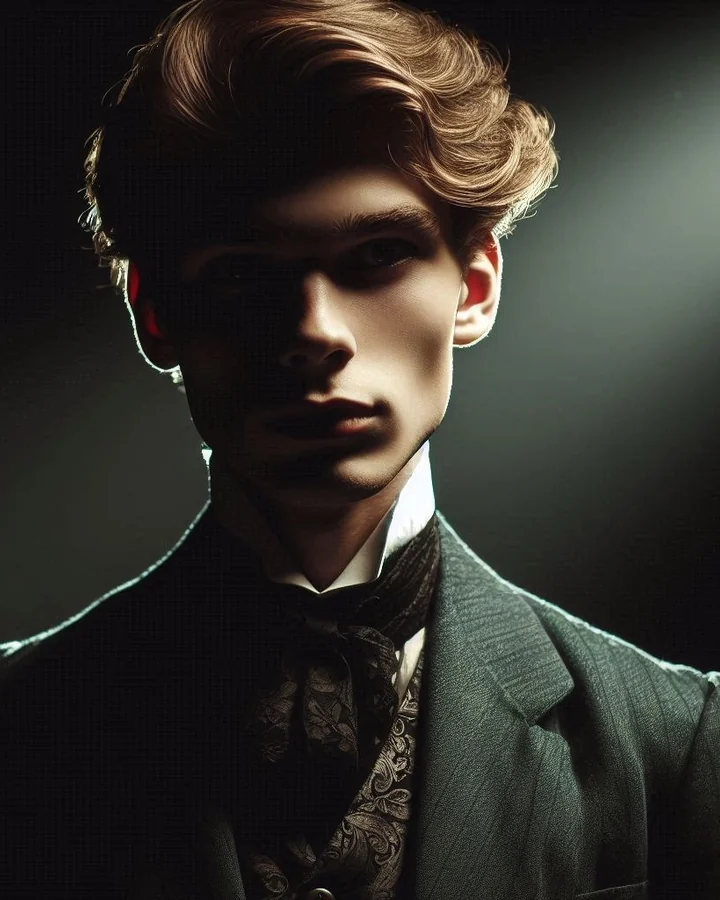
Cassius
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Shanikua
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
The Dracolyr Crisis
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Kyle
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Akari Saito
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Rowan
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Aria, the Lighthouse Keeper
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Sieglinde Seyfried
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
XERUS, CHAOS INCARNATE
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Rosivelle
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Ezekiel
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
Ruthanne
Publiczny profil Oryginalnej Postaci zaobserwowany 19 października 2026.
WYBÓR TRYBU
Którą trasę Hammer AI powinieneś wybrać?
Wybór modelu zaczyna się od ograniczeń, nie od nazw marek. Zdecyduj, czy dane mogą opuścić urządzenie, oszacuj dostępną pamięć, wybierz akceptowalny cel prędkości i dopiero wtedy porównaj pliki modeli lub poziomy hostowane.
| Decyzja | Trasa lokalna (desktop) | Trasa hostowana |
|---|---|---|
| Ścieżka danych | Inferencja może pozostać na komputerze, gdy wybrano model lokalny i zweryfikowano offline. | Dane wejściowe i wyjściowe trafiają do usługi lub dostawcy AI; mogą obowiązywać zasady przechowywania dostawcy.[1][2] |
| Sprzęt | Plik modelu musi zmieścić się w RAM lub VRAM z dodatkowym miejscem na kontekst i aplikację.[3] | Usługa zapewnia moc obliczeniową, zmniejszając wymagania lokalne, ale dodając zależność od sieci. |
| Wybór modelu | Skwantyzowane pliki oferują różne kompromisy między rozmiarem a jakością; możliwe są niestandardowe konfiguracje lokalne. | Usługa kontroluje dostępny katalog, limity i harmonogram wycofywania. |
| Użycie offline | Możliwe po pobraniu aplikacji i plików modelu; przetestuj, odłączając sieć.[1] | To nie jest przepływ offline. |
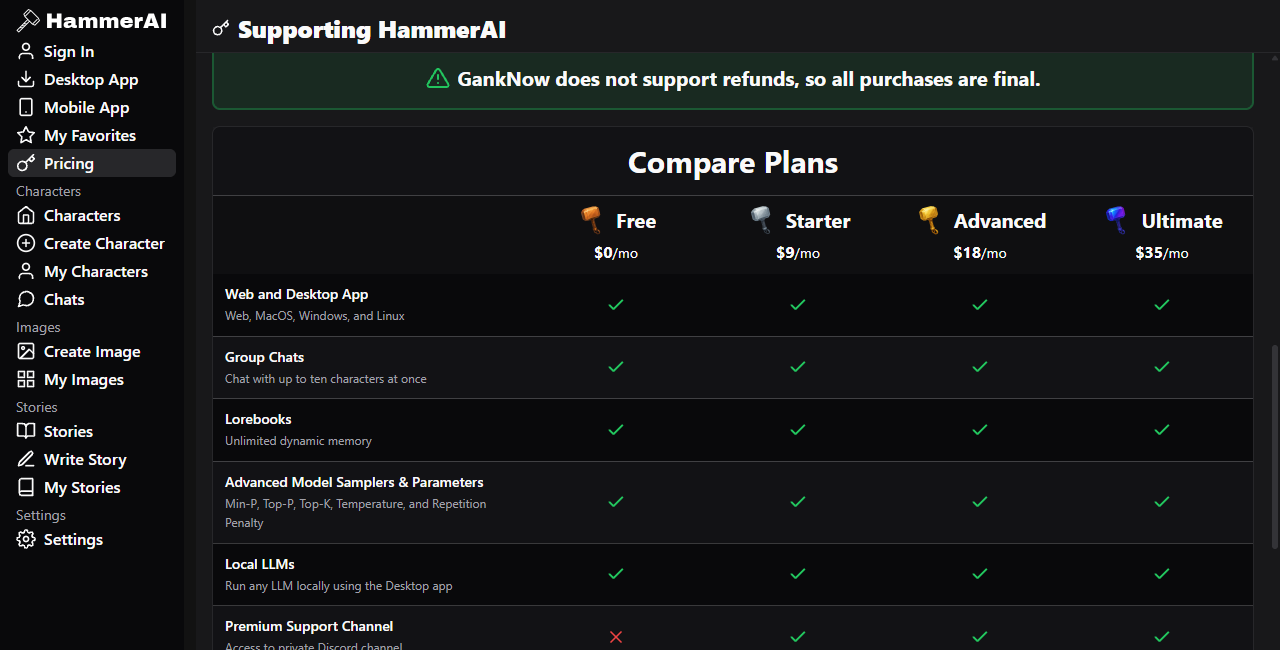
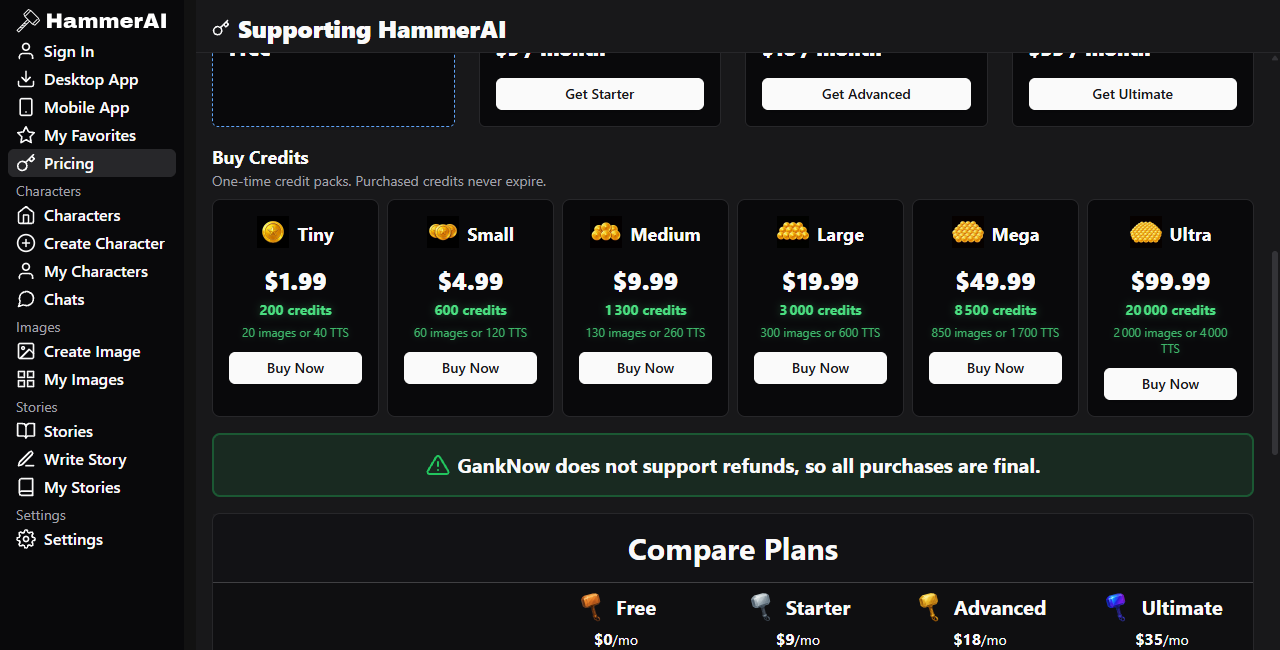
| Wzorzec kosztów | Lokalny czat jest promowany jako darmowy, ale sprzęt, przechowywanie i prąd to koszty użytkownika. | Darmowe limity, subskrypcje i jednorazowe kredyty mogą się zmieniać na stronie cenowej.[4] |
| Najlepsze dopasowanie | Prywatne szkice, eksperymenty, powtarzalne testy i użytkownicy gotowi zarządzać zasobami lokalnymi. | Wygoda na wielu urządzeniach, ograniczony sprzęt lokalny i funkcje dostępne tylko online. |
METODA
Jak powstała ta recenzja Hammer AI?
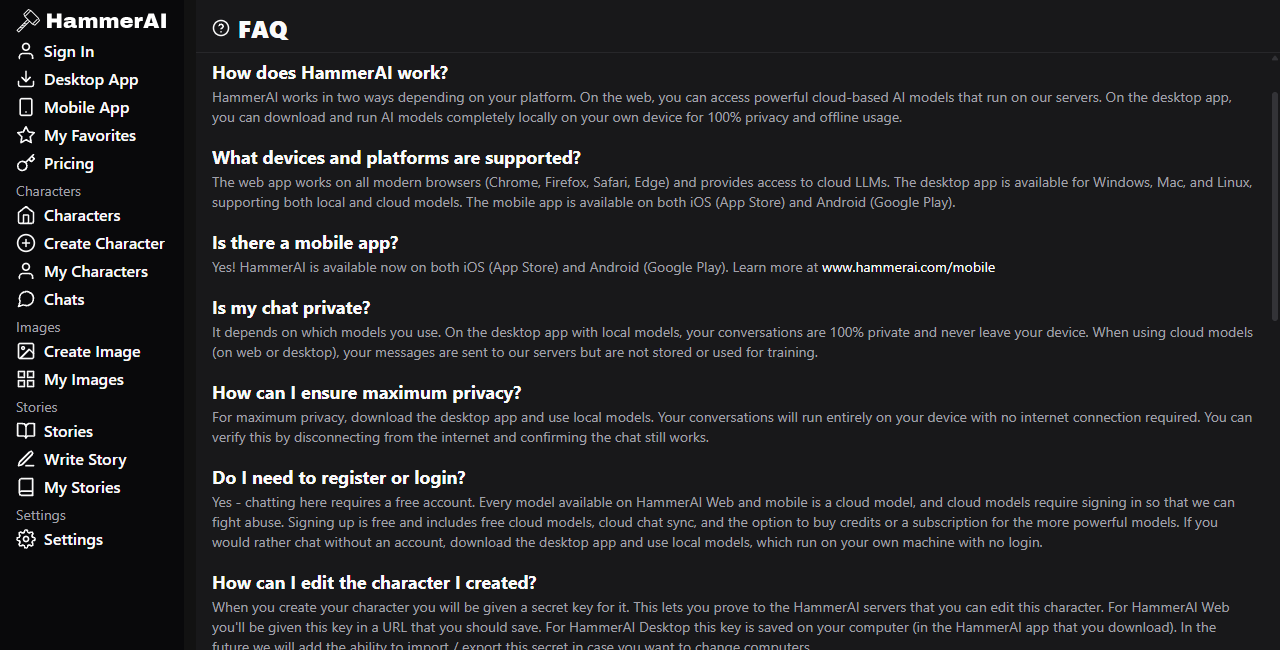
Recenzja wykorzystuje publiczne oficjalne strony i zachowane zrzuty przeglądarki z datą 19 października 2026. Nie użyto logowania, prywatnych rozmów, płatnych transakcji ani benchmarków modeli. Zrzuty ekranu dokumentują widoczne kontrolki i sformułowania, a nie zachowanie backendu. Gdzie oficjalne strony są sprzeczne, ten przewodnik wskazuje sprzeczność i faworyzuje bardziej szczegółową politykę prywatności nad krótszym podsumowaniem marketingowym lub FAQ.
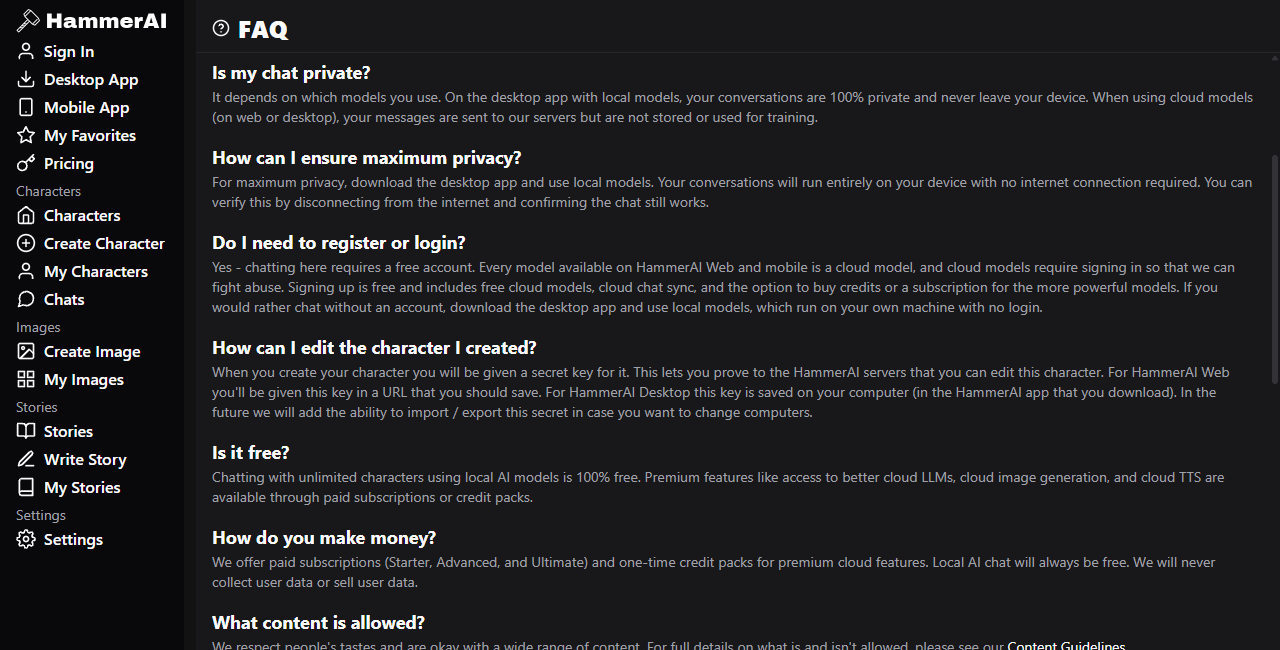
To ważne, ponieważ publiczne FAQ mówi, że hostowane wiadomości nie są przechowywane ani używane do szkolenia, podczas gdy polityka prywatności mówi, że zewnętrzni dostawcy AI mogą przechowywać dane wejściowe i wyjściowe i mogą je wykorzystywać zgodnie z własnymi politykami. Polityka opisuje również reklamy kontekstowe dla niektórych darmowych usług online. Tych stwierdzeń nie można bezpiecznie skompresować do „chmura jest prywatna”.[1][2]
MAPA SYSTEMU
Jak Hammer AI jest podzielony na systemy lokalne, hostowane i kreatywne?
Lokalna inferencja na komputerze
Wybrany model lokalny działa na sprzęcie użytkownika. Publiczne FAQ opisuje test weryfikacji offline i mówi, że trasa lokalna może działać bez konta.[1]
- Wymaga pobrania aplikacji i modeli.
- Wydajność zależy od limitów RAM, VRAM, CPU lub GPU.
- Lokalne wyniki mogą być nadal niedokładne lub niebezpieczne.
Hostowane modele językowe
Żądania hostowane korzystają z mocy zdalnej. Polityka prywatności mówi, że zewnętrzni dostawcy AI mogą otrzymywać prompty i wyniki, a ich zasady przechowywania lub szkolenia mogą mieć zastosowanie.[2]
- Wymaga połączenia sieciowego.
- Katalog i limity kontekstu są kontrolowane przez usługę.
- Zasady konta lub planu mogą się zmieniać.
Warstwa usług kreatywnych
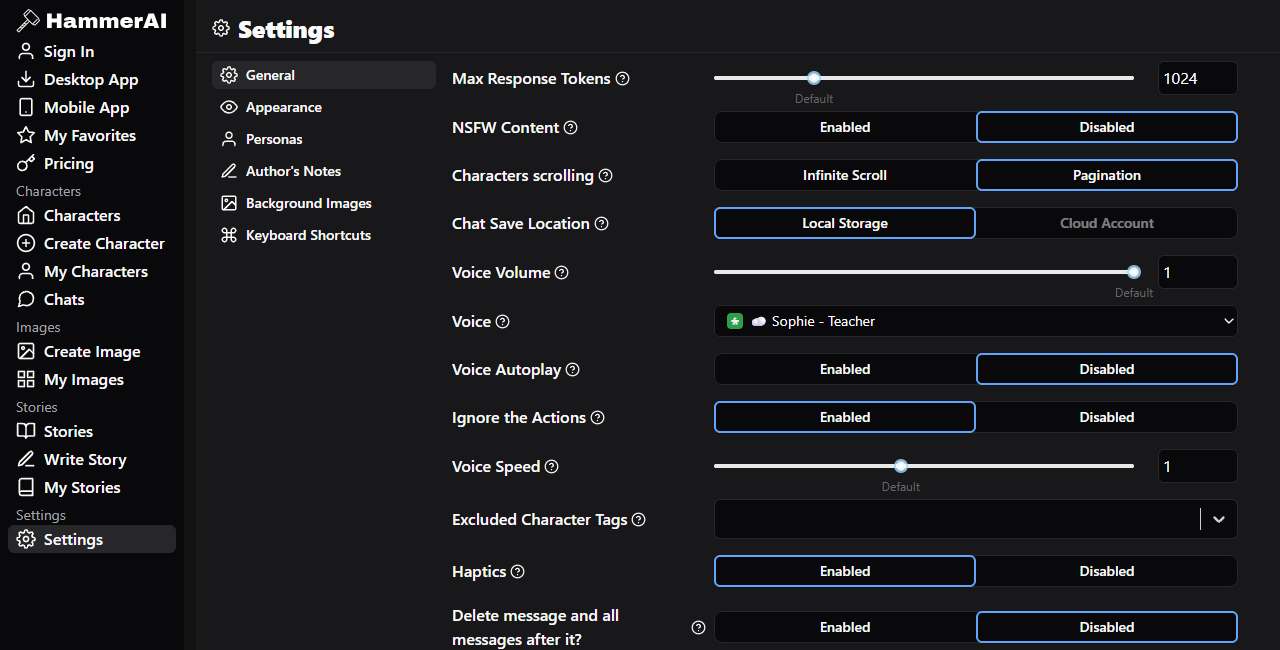
Definicje postaci, lorebooki, narzędzia opowieści, generowanie obrazów, mowa i kontrolki preferencji otaczają trasę modelu. Każda część może mieć własne zasady przechowywania, dostawcę i kredyty.
- Pola promptu wpływają na zachowanie, nie na prawdę.
- Obrazy i mowę należy oceniać jako usługi online.
- Synchronizacja to osobna ścieżka danych.
PROCEDURA
Jak dobrać rozmiar i przetestować lokalny model Hammer AI?
Zinwentaryzuj maszynę
Zapisz pamięć systemową, dedykowaną pamięć graficzną, wolne miejsce na dysku i system operacyjny. Nie wybieraj modelu tylko na podstawie liczby parametrów lub nazwy.
Wybierz konserwatywny plik
Oficjalny przewodnik po kwantyzacji opisuje skompresowane warianty modeli i zaleca pozostawienie pamięci na kontekst i inne oprogramowanie. Mniejsze pliki ładują się łatwiej; agresywna kompresja może obniżyć jakość.[3]
Ustal zestaw promptów
Użyj kilku powtarzalnych promptów obejmujących podążanie za instrukcjami, dialog, długi kontekst i zachowanie odmowy. Stały zestaw czyni porównania modeli bardziej użytecznymi niż pojedyncza imponująca odpowiedź.
Zmierz rzeczywiste wąskie gardło
Obserwuj czas ładowania, czas do pierwszego tokena, ciągłą prędkość odpowiedzi i ciśnienie pamięci. Model, który mieści się na dysku, ale ciągle wymienia pamięć, nie jest praktycznym wyborem.
Zweryfikuj ścieżkę danych
Odłącz sieć i powtórz nieszkodliwy prompt. Jeśli czat się zatrzyma, zależność hostowana jest nadal aktywna. Jeśli działa dalej, zapisz wybrany model i konfigurację, aby test był powtarzalny.[1]
TABLICE DOWODOWE
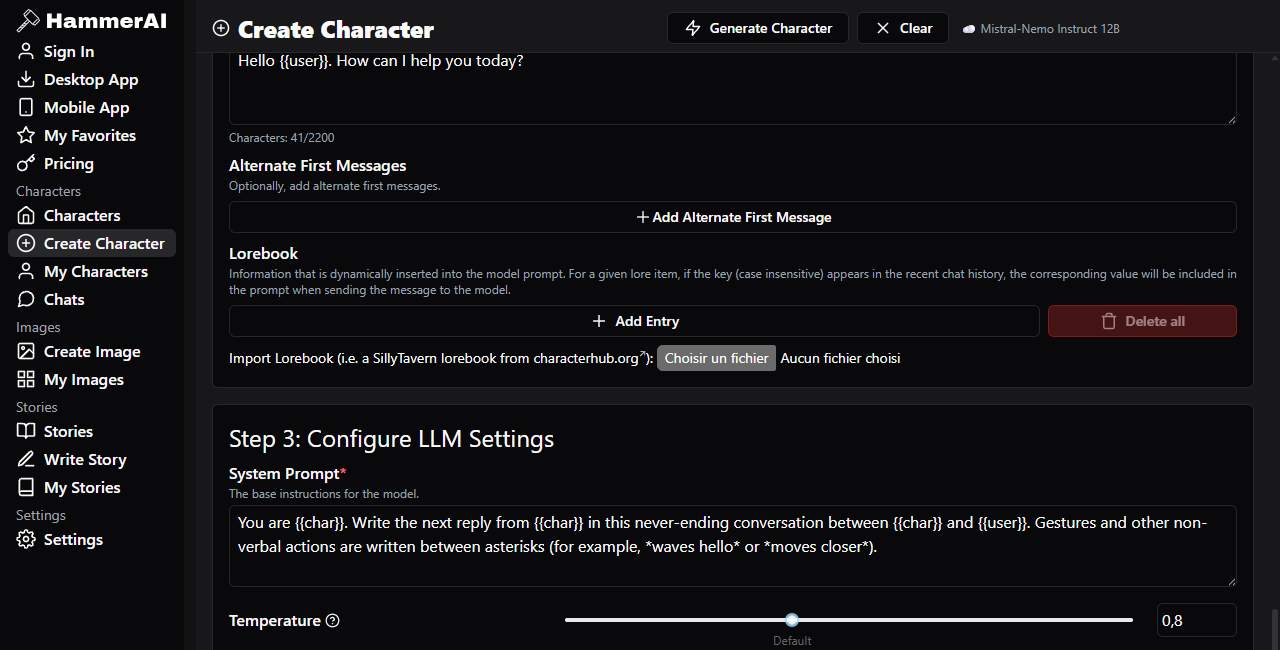
Co właściwie dowodzą zachowane zrzuty ekranu Hammer AI?
Każda tablica wspiera wąską obserwację widocznego interfejsu. Żadna nie dowodzi jakości modelu, zachowania serwera ani aktualnej dostępności po dacie przechwycenia.
MACIERZ ODBIORCÓW
Kto korzysta z Hammer AI, i co może pójść nie tak?
Prywatne miejsce do szkicowania
Dobre dopasowanie: pisarze, którzy mogą zweryfikować lokalną inferencję i chcą narzędzia do burzy mózgów offline. Tryb awarii: pozostawianie wrażliwych eksportów, kopii zapasowych lub logów bez ochrony na tej samej maszynie.
Prototypowanie systemów postaci
Dobre dopasowanie: twórcy testujący strukturę persony, scenariusza, przykładów i lore. Tryb awarii: traktowanie większej liczby pól promptu jako gwarancji spójnego zachowania.
Porównanie modeli lokalnych
Dobre dopasowanie: użytkownicy porównujący rozmiary plików, kwantyzacje i ustawienia próbkowania. Tryb awarii: zmienianie kilku kontrolek naraz i wyciąganie wniosków z jednego promptu.
Wygoda hostowana
Dobre dopasowanie: użytkownicy z ograniczonym sprzętem lub potrzebami na wielu urządzeniach. Tryb awarii: poleganie na krótkim zdaniu o prywatności w FAQ bez czytania ujawnień dostawcy i reklam.[1][2]
Pomysły na obrazy i głos
Dobre dopasowanie: eksperymenty kreatywne niskiego ryzyka po sprawdzeniu aktualnych kredytów. Tryb awarii: przesyłanie prywatnych, chronionych prawem autorskim lub identyfikujących materiałów bez zrozumienia trasy online.
Profesjonalne wsparcie decyzyjne
Słabe dopasowanie: decyzje medyczne, prawne, finansowe, bezpieczeństwa lub awaryjne. Wygenerowana pewność nie jest dowodem, a lokalne wykonanie nie poprawia odpowiedzialności za fakty.
CZYTANIE PRYWATNOŚCI
Jak interpretować roszczenia prywatności Hammer AI?
Użyj warstwowej interpretacji. Po pierwsze, zweryfikowany lokalny model desktopowy może utrzymać inferencję na komputerze i działać bez połączenia sieciowego. Po drugie, szerszy produkt nadal ma konta, diagnostykę, subskrypcje, infrastrukturę i usługi online. Po trzecie, polityka prywatności mówi, że zewnętrzni dostawcy AI mogą przetwarzać i przechowywać hostowane prompty i wyniki, a niektóre darmowe usługi internetowe lub mobilne mogą wysyłać ostatnie treści do reklam kontekstowych. Obronne stwierdzenie to: Hammer AI oferuje trasę lokalną, a nie że każda funkcja jest offline lub bez dostawcy.[1][2] Hammer AI
Do wrażliwej pracy zapisz dokładny klient, wybrany model, stan logowania, stan sieci i włączone funkcje. Unikaj obrazów w chmurze, mowy lub synchronizacji, chyba że ich aktualna polityka jest akceptowalna. Przechowywanie na urządzeniu i lokalna inferencja to różne właściwości i należy je testować osobno.
WERDYKT
Kiedy Hammer AI ma sens techniczny?
Hammer AI ma sens, gdy użytkownik chce jednego interfejsu do lokalnego czatu z modelami i ustrukturyzowanych przepływów postaci bez budowania własnego frontendu. Jego wartość to praktyczna integracja: wybór modelu, prompty postaci, lore, opowieści, narzędzia medialne i preferencje w jednym produkcie. Kosztem tej szerokości jest niejednoznaczność. Granica prywatności zmienia się w zależności od trybu, lokalne doświadczenie zmienia się wraz ze sprzętem, a katalogi online lub limity mogą się zmienić bez czynienia starego zrzutu ekranu fałszywym.
Wybierz go do eksperymentów, które możesz zweryfikować, i wyników, które przejrzysz. Nie wybieraj go z założeniem, że każda funkcja jest lokalna, że większy model jest zawsze lepszy, lub że opublikowane szczegóły planu pozostaną stałe. Oficjalne Warunki ograniczają korzystanie do dorosłych i nakładają na użytkownika odpowiedzialność za zgodne z prawem użycie i wygenerowane treści.[5]
Poznaj serwis z postaciami AIFAQ
Jakie pytania techniczne należy zadać przed użyciem Hammer AI?
Czy Hammer AI może działać w pełni offline?
Lokalny czat desktopowy może działać offline po instalacji i pobraniu modelu. Hostowane modele, synchronizacja, generowanie obrazów i mowa powinny być zakładane jako wymagające połączenia, chyba że aktualny interfejs wyraźnie dowodzi inaczej.[1]
Ile pamięci potrzebuje model?
Plik modelu musi zmieścić się w dostępnym RAM lub VRAM z dodatkowym miejscem na kontekst i aplikację. Kwantyzacja zmniejsza wymagania dotyczące pliku i pamięci, ale silniejsza kompresja może obniżyć jakość wyników.[3]
Czy lokalny model czyni wyniki wiarygodnymi?
Nie. Lokalny opisuje, gdzie odbywa się inferencja, a nie czy odpowiedź jest dokładna, bezstronna lub bezpieczna. Stosuj te same standardy weryfikacji do wyników lokalnych i hostowanych.
Czy dostawcy Hammer AI mogą szkolić się na czatach w chmurze?
Polityka prywatności mówi, że zewnętrzni dostawcy AI mogą przechowywać dane wejściowe i wyjściowe i mogą ich używać do ulepszania lub szkolenia swoich modeli zgodnie z własnymi politykami. Sprawdź warunki nazwanego dostawcy widoczne w aktualnej usłudze.[2]
Czy przechwycone ceny są nadal aktualne?
Niekoniecznie. Zachowane zrzuty ekranu dowodzą, co strona wyświetlała w momencie przechwycenia. Aktualna strona cenowa jest źródłem bieżących subskrypcji, kredytów, limitów kontekstu i dostępu do modeli.[4]
Czy Hammer AI jest przeznaczony dla nieletnich?
Nie. Oficjalne Warunki mówią, że użytkownicy muszą mieć co najmniej 18 lat lub wiek zgody w swojej jurysdykcji, w zależności od tego, który jest wyższy.[5]
ŹRÓDŁA
Które oficjalne źródła wspierają ten przewodnik terenowy?
- [1] FAQ Hammer AI — opisy tras, test offline i stwierdzenia o kontach.
- [2] Polityka prywatności Hammer AI — dostawcy hostowani, reklamy kontekstowe, konta i diagnostyka.
- [3] Przewodnik po modelach i kwantyzacji Hammer AI — pamięć, rozmiar pliku i kompromisy kompresji.
- [4] Strona cenowa Hammer AI — aktualne plany, limity i prezentacja kredytów.
- [5] Warunki Hammer AI — kwalifikowalność dorosłych, odpowiedzialność użytkownika i warunki usługi.
Data obserwacji: 19 października 2026. Zrzuty produktów, katalogi modeli, język prywatności i limity komercyjne mogą się zmienić. Aktualne oficjalne strony mają pierwszeństwo przed zachowanymi zrzutami.