RÉSUMÉ
Hammer AI guide technique : modèles, modes et confidentialité
Hammer AI combine un client desktop avec modèles locaux et des services de chat et de création hébergés. Cette architecture offre plus de choix qu'une interface cloud uniquement, mais rend les étiquettes générales peu fiables. Une revue utile doit identifier la route de modèle active, le chemin des données, l'exigence matérielle et les conditions commerciales actuelles pour chaque flux de travail.
- Route locale
- Inférence de modèle sur le bureau
- Route hébergée
- Traitement des modèles dans le cloud
- Contrainte principale
- Mémoire plus taille du modèle
- Règle de revue
- Vérifier chaque fonctionnalité séparément
Publication indépendante. Les contrôles commerciaux et les images de preuve renvoient à un service tiers distinct.
RÉPONSE D'ABORD
Qu'est-ce que Hammer AI en termes techniques ?
Hammer AI est une couche applicative pour le chat de personnages, les histoires et les flux de travail médias qui peut faire appel à des modèles de langage locaux sur le bureau ou à des services hébergés. L'inférence locale peut garder une conversation sur l'ordinateur de l'utilisateur et fonctionner hors ligne après configuration ; le chat hébergé, les images, la parole et la synchronisation peuvent utiliser l'infrastructure de ou des fournisseurs tiers. La politique de confidentialité actuelle est la source faisant autorité pour les décisions en ligne, car les affirmations plus courtes de la FAQ ne décrivent pas chaque fournisseur ou chemin de service gratuit.[1][2] Hammer AI
INDEX DES PERSONNAGES
15 personnages originaux observés dans le catalogue public
Cet index visuel échantillonne quinze profils de personnages originaux publics observés sur Hammer AI. Il ne documente que la variété du catalogue : les profils, les noms et la disponibilité peuvent changer après la date d'observation.
Taleia Vonn
Profil de personnage original public observé le 19 octobre 2026.
Kylie
Profil de personnage original public observé le 19 octobre 2026.
Victoria "Vicky" Hartley
Profil de personnage original public observé le 19 octobre 2026.
Cassius
Profil de personnage original public observé le 19 octobre 2026.
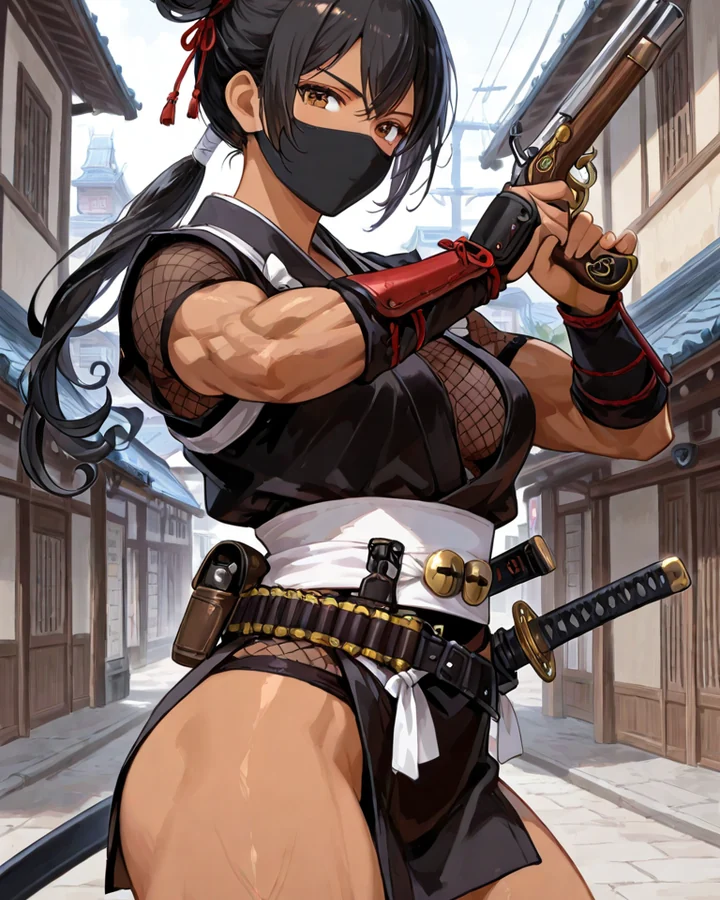
Shanikua
Profil de personnage original public observé le 19 octobre 2026.
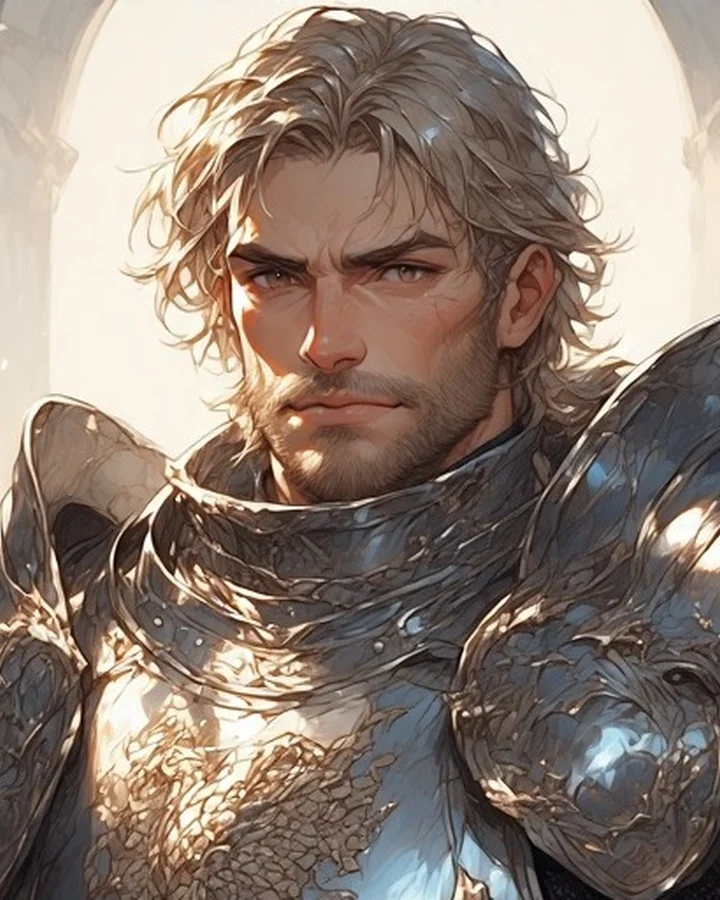
The Dracolyr Crisis
Profil de personnage original public observé le 19 octobre 2026.
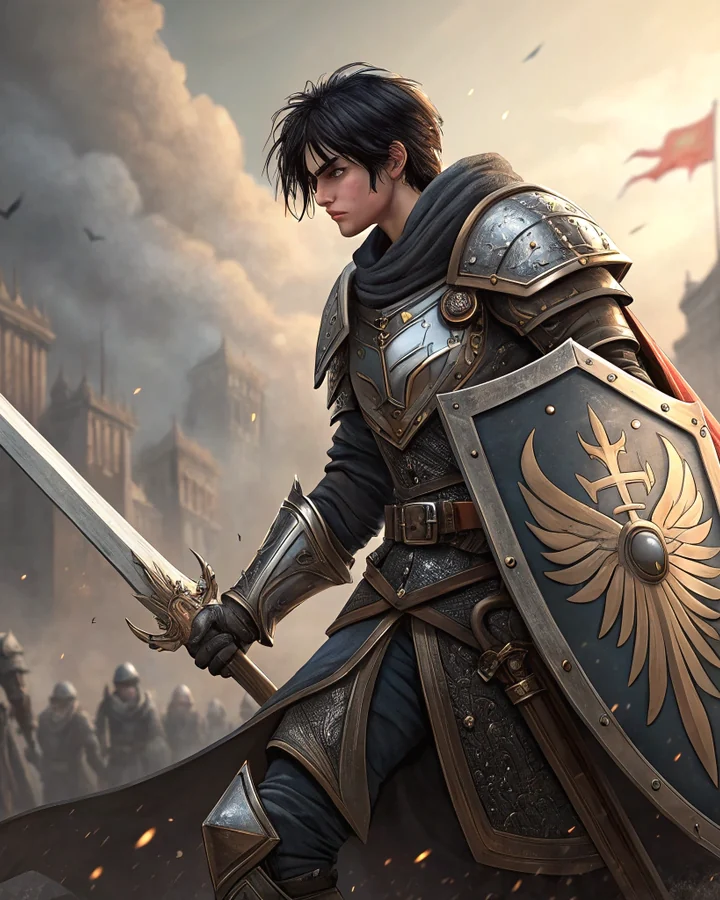
Kyle
Profil de personnage original public observé le 19 octobre 2026.
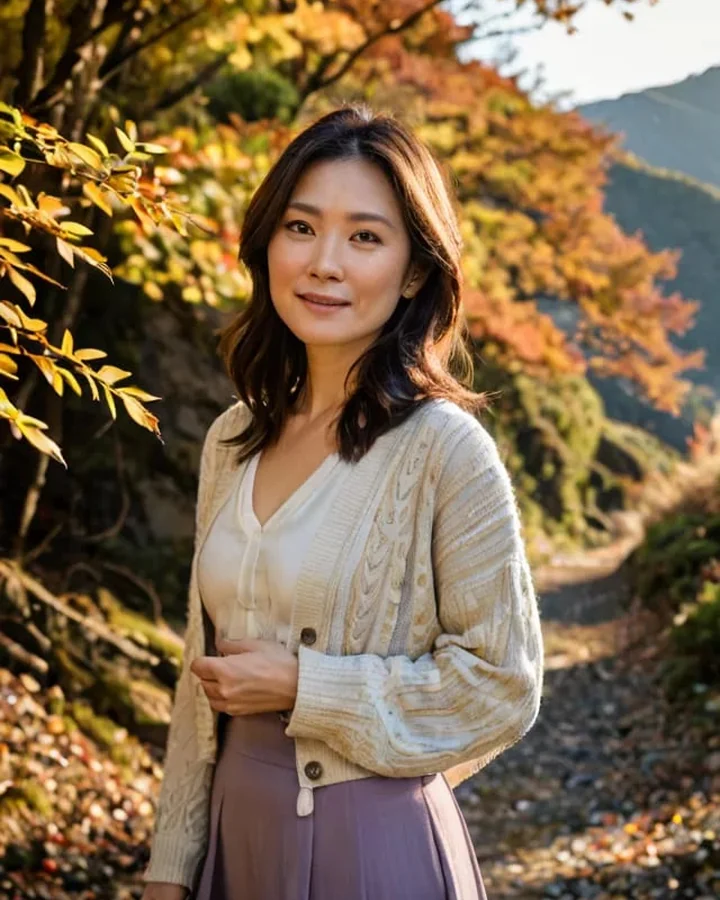
Akari Saito
Profil de personnage original public observé le 19 octobre 2026.
Rowan
Profil de personnage original public observé le 19 octobre 2026.
Aria, the Lighthouse Keeper
Profil de personnage original public observé le 19 octobre 2026.
Sieglinde Seyfried
Profil de personnage original public observé le 19 octobre 2026.
XERUS, CHAOS INCARNATE
Profil de personnage original public observé le 19 octobre 2026.
Rosivelle
Profil de personnage original public observé le 19 octobre 2026.
Ezekiel
Profil de personnage original public observé le 19 octobre 2026.
Ruthanne
Profil de personnage original public observé le 19 octobre 2026.
SÉLECTION DU MODE
Quelle route Hammer AI devriez-vous choisir ?
La sélection du modèle commence par les contraintes, pas par les noms de marque. Décidez si les données peuvent quitter l'appareil, estimez la mémoire disponible, choisissez une cible de vitesse acceptable et seulement ensuite comparez les fichiers de modèles ou les niveaux hébergés.
| Décision | Route locale sur bureau | Route hébergée |
|---|---|---|
| Chemin des données | L'inférence peut rester sur l'ordinateur lorsqu'un modèle local est sélectionné et vérifié hors ligne. | Les entrées et sorties voyagent vers un service ou un fournisseur IA ; les règles de conservation du fournisseur peuvent s'appliquer.[1][2] |
| Matériel | Le fichier du modèle doit tenir dans la RAM ou la VRAM avec de l'espace supplémentaire pour le contexte et l'application.[3] | Le service fournit la puissance de calcul, réduisant les exigences locales mais ajoutant une dépendance au réseau. |
| Choix du modèle | Les fichiers quantifiés offrent différents compromis taille/qualité ; des configurations locales personnalisées peuvent être possibles. | Le service contrôle le catalogue disponible, les limites et le calendrier de retrait. |
| Utilisation hors ligne | Possible après que l'application et les fichiers du modèle sont présents ; testez en déconnectant le réseau.[1] | Pas un flux de travail hors ligne. |
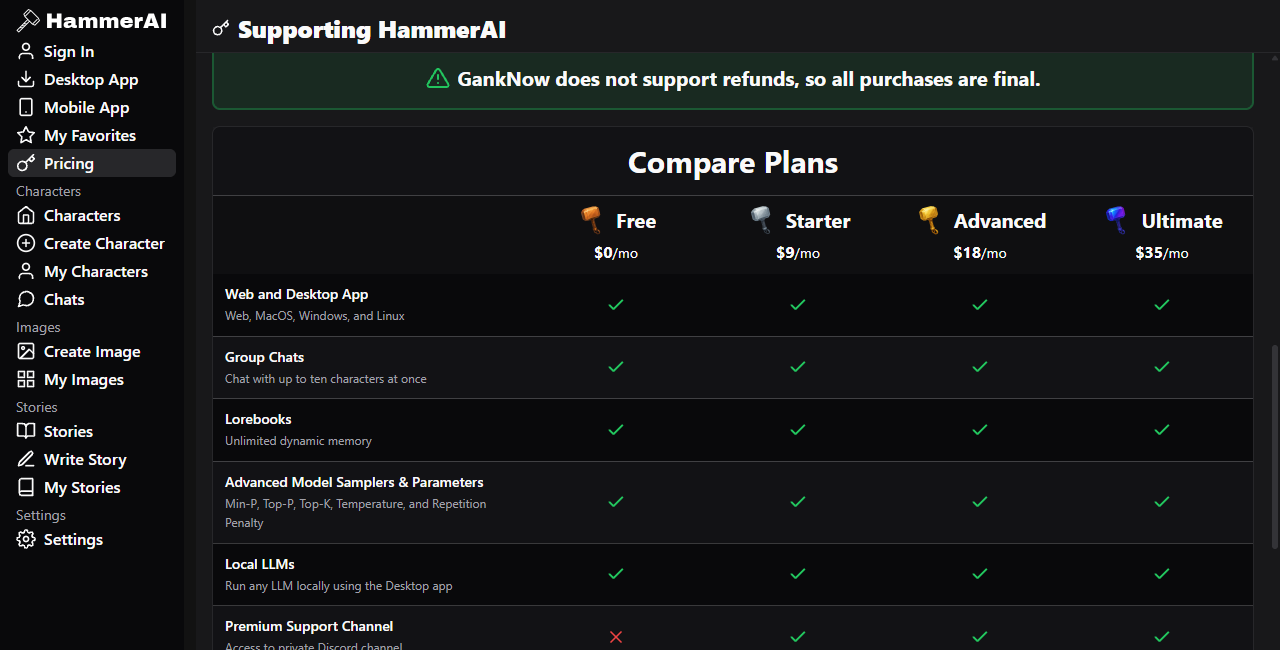
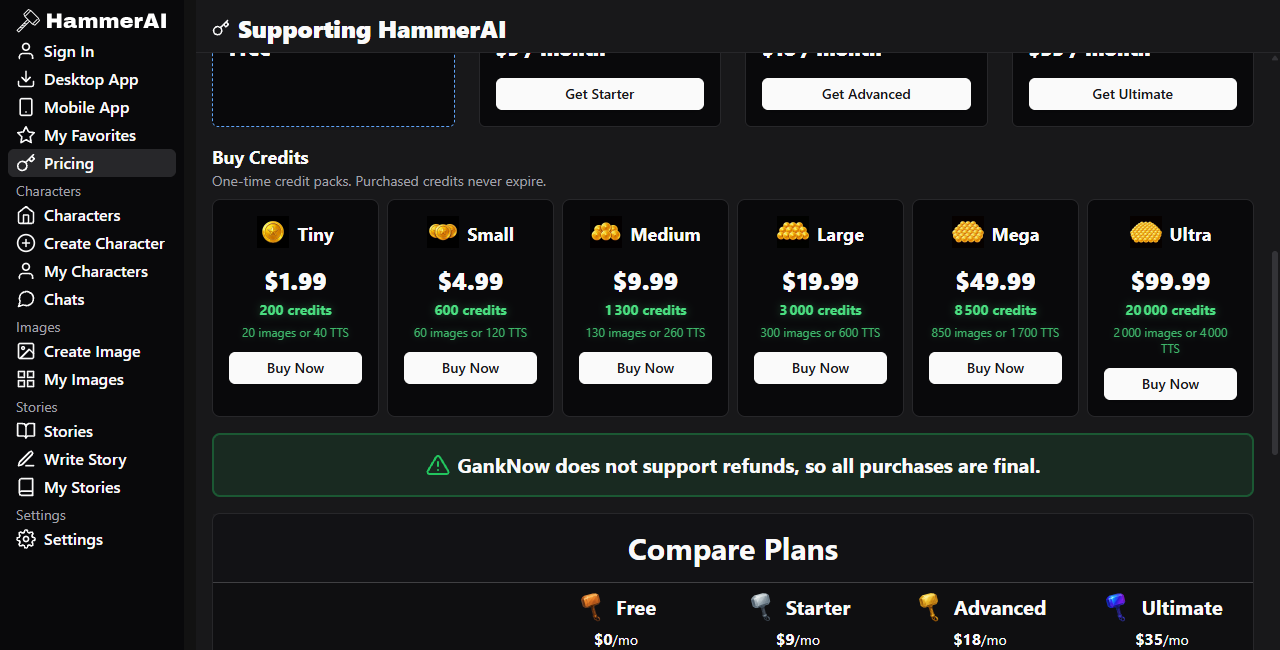
| Modèle de coût | Le chat local est présenté comme gratuit, mais le matériel, le stockage et l'électricité sont des coûts pour l'utilisateur. | Les allocations gratuites, les abonnements et les crédits uniques peuvent changer sur la page de tarification en direct.[4] |
| Meilleure adaptation | Brouillons privés, expérimentation, tests reproductibles et utilisateurs prêts à gérer des ressources locales. | Commodité multi-appareils, matériel local limité et fonctionnalités uniquement offertes en ligne. |
MÉTHODE
Comment cette revue Hammer AI a-t-elle été assemblée ?
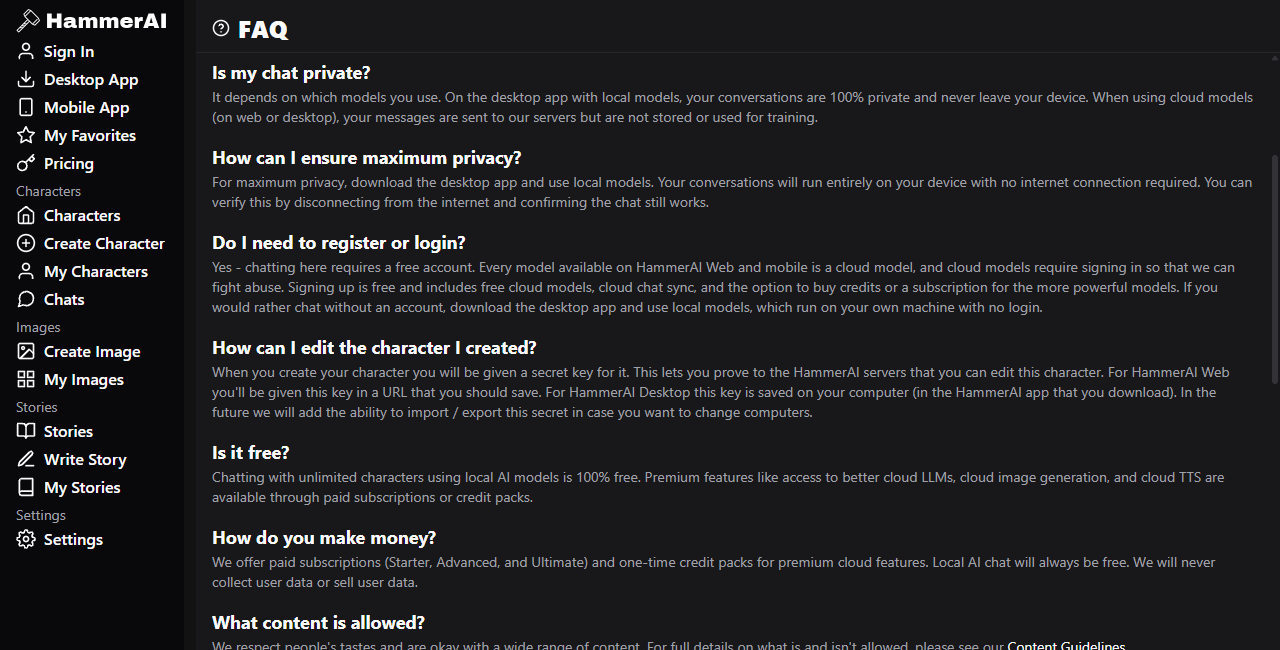
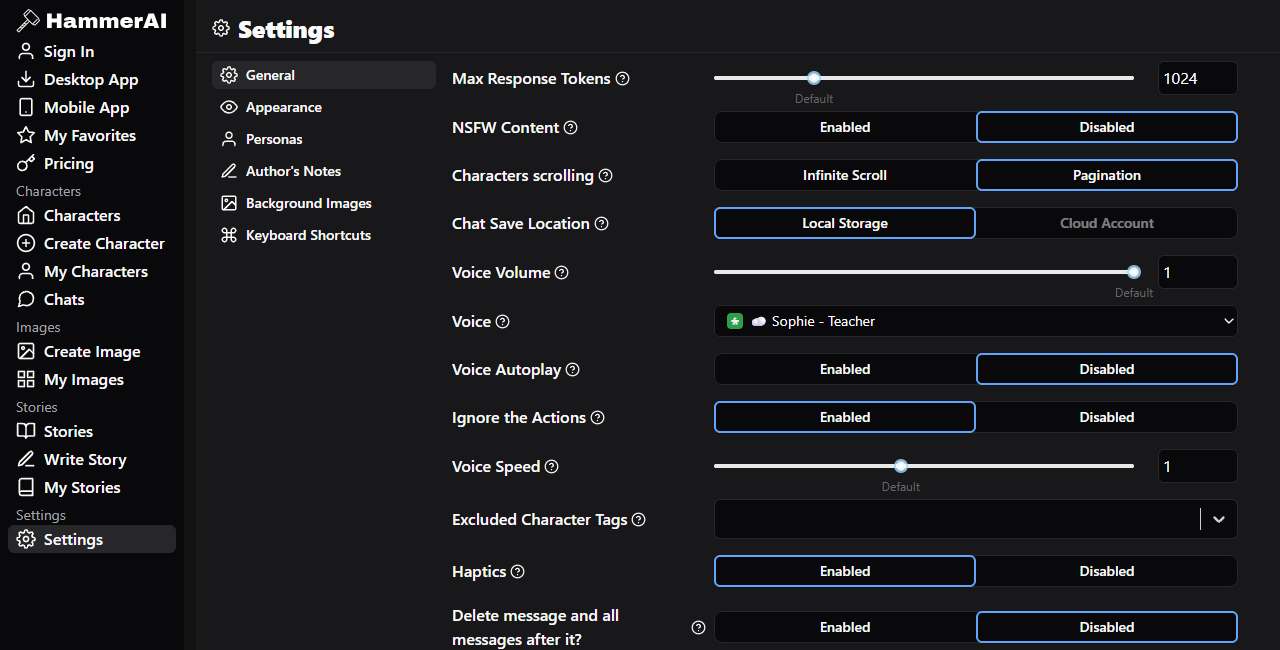
La revue utilise des pages officielles publiques et des captures de navigateur conservées datées du 19 octobre 2026. Aucune connexion, conversation privée, transaction payante ou benchmark de modèle n'a été utilisée. Les captures d'écran documentent les contrôles visibles et le texte, pas le comportement du backend. Lorsque les pages officielles sont en conflit, ce guide nomme le conflit et favorise la politique de confidentialité plus détaillée plutôt qu'un résumé marketing ou FAQ plus court.
Cela compte car la FAQ publique dit que les messages hébergés ne sont pas stockés ou utilisés pour l'entraînement, tandis que la politique de confidentialité dit que les fournisseurs IA tiers peuvent conserver les entrées et sorties et peuvent les utiliser selon leurs propres politiques. La politique décrit également la publicité contextuelle pour certains services en ligne gratuits. Ces déclarations ne peuvent pas être compressées en toute sécurité en « le cloud est privé ».[1][2]
CARTE DU SYSTÈME
Comment Hammer AI est-il divisé entre les systèmes locaux, hébergés et créatifs ?
Inférence locale sur bureau
Un modèle local sélectionné s'exécute sur le matériel de l'utilisateur. La FAQ publique décrit un test de vérification hors ligne et dit qu'une route locale peut fonctionner sans compte.[1]
- Nécessite des téléchargements d'application et de modèle.
- La performance suit les limites de RAM, VRAM, CPU ou GPU.
- La sortie locale peut toujours être inexacte ou dangereuse.
Modèles de langage hébergés
Les requêtes hébergées utilisent le calcul à distance. La politique de confidentialité dit que les fournisseurs IA externes peuvent recevoir des prompts et des sorties, et leurs conditions de conservation ou d'entraînement peuvent s'appliquer.[2]
- Nécessite une connexion réseau.
- Le catalogue et les limites de contexte sont contrôlés par le service.
- Les règles de compte ou de plan peuvent changer.
Couche de service créatif
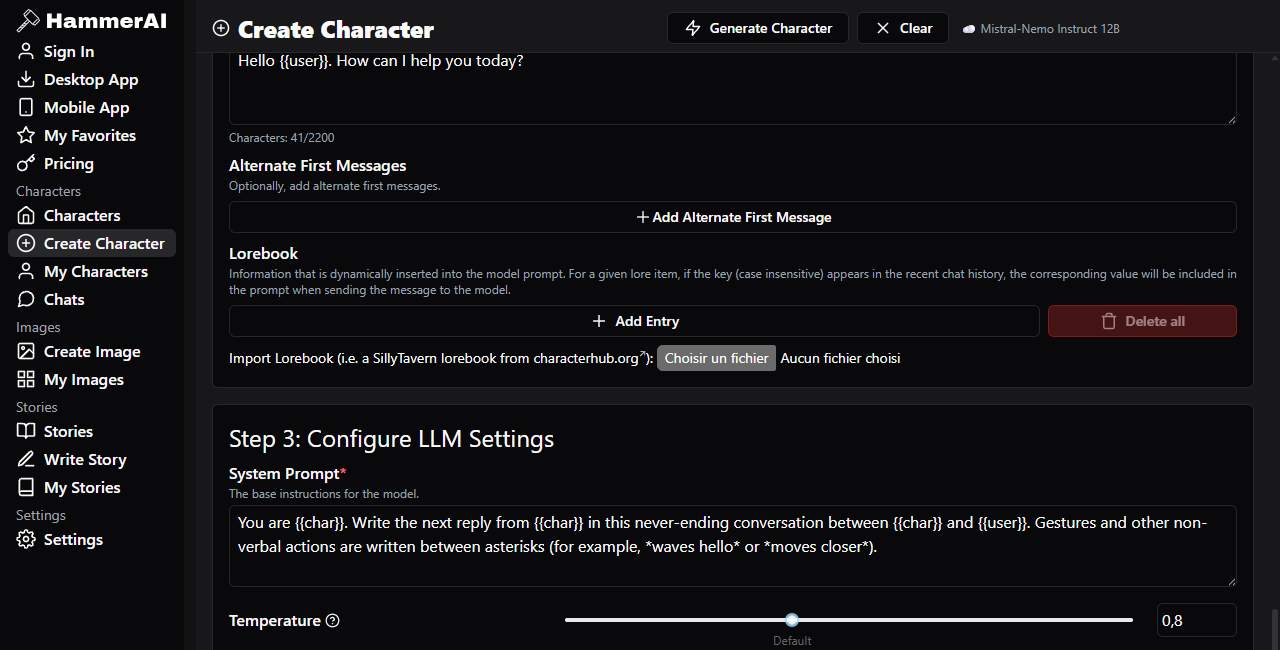
Les définitions de personnages, les lorebooks, les outils d'histoire, la génération d'images, la parole et les contrôles de préférences entourent la route du modèle. Chaque partie peut avoir son propre stockage, fournisseur et règles de crédit.
- Les champs de prompt influencent le comportement, pas la vérité.
- Les images et la parole doivent être évaluées comme des services en ligne.
- La synchronisation est un chemin de données séparé.
PROCÉDURE
Comment dimensionner et tester un modèle local Hammer AI ?
Inventorier la machine
Enregistrez la mémoire système, la mémoire graphique dédiée, l'espace disque libre et le système d'exploitation. Ne choisissez pas un modèle uniquement sur son nombre de paramètres ou son nom.
Choisir un fichier conservateur
Le guide officiel de quantification décrit des variantes de modèles compressés et recommande de laisser de la mémoire pour le contexte et d'autres logiciels. Les fichiers plus petits se chargent plus facilement ; une compression agressive peut réduire la qualité.[3]
Établir un ensemble de prompts
Utilisez quelques prompts reproductibles couvrant le suivi d'instructions, le dialogue, le long contexte et le comportement de refus. Un ensemble fixe rend les comparaisons de modèles plus utiles qu'une seule réponse impressionnante.
Mesurer le vrai goulot d'étranglement
Surveillez le temps de chargement, le temps jusqu'au premier jeton, la vitesse de réponse continue et la pression mémoire. Un modèle qui tient sur le disque mais qui échange constamment de la mémoire n'est pas un choix pratique.
Vérifier le chemin des données
Déconnectez le réseau et répétez un prompt inoffensif. Si le chat s'arrête, une dépendance hébergée est toujours active. S'il continue, enregistrez le modèle sélectionné et la configuration pour que le test soit reproductible.[1]
PLANCHES DE PREUVE
Que prouvent réellement les captures d'écran Hammer AI conservées ?
Chaque planche soutient une observation étroite sur l'interface visible. Aucune ne prouve la qualité du modèle, le comportement du serveur ou la disponibilité actuelle après la date de capture.
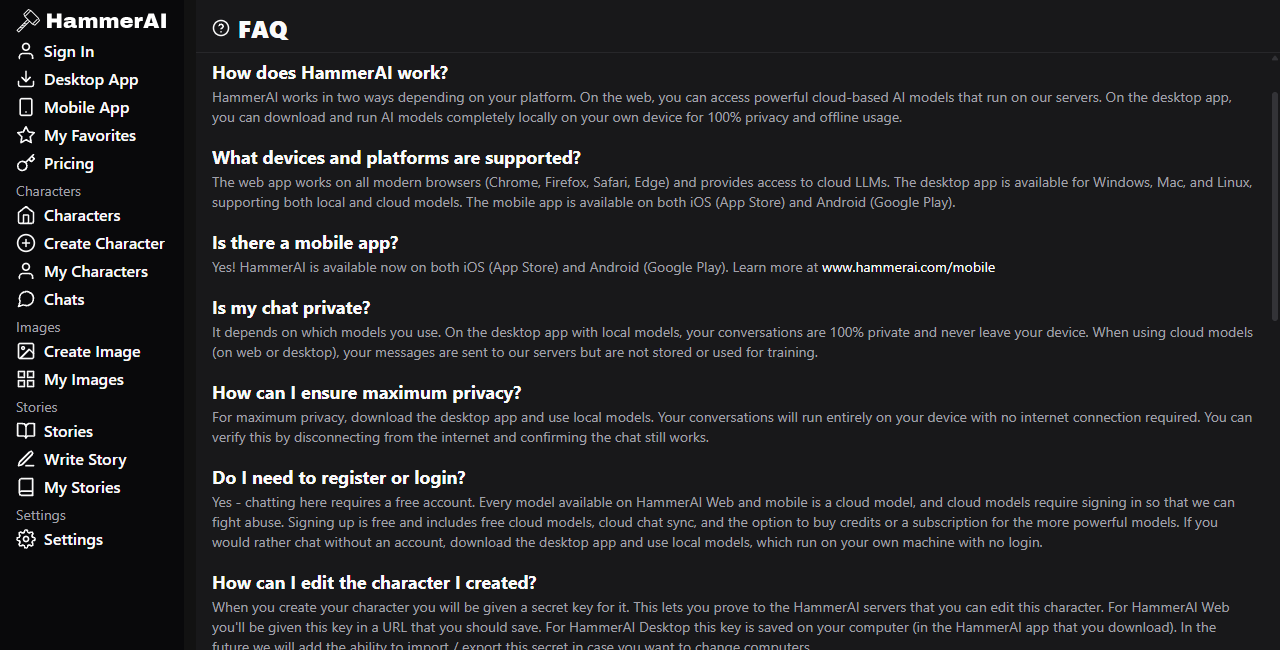
MATRICE D'AUDIENCE
Qui bénéficie de Hammer AI, et qu'est-ce qui peut mal tourner ?
Espace de travail de brouillon privé
Bon ajustement : écrivains qui peuvent vérifier l'inférence locale et veulent un outil de brainstorming hors ligne. Mode de défaillance : laisser des exports sensibles, des sauvegardes ou des journaux non protégés sur la même machine.
Prototypage de système de personnage
Bon ajustement : créateurs testant la structure de persona, scénario, exemples et lore. Mode de défaillance : traiter plus de champs de prompt comme une garantie de comportement cohérent.
Comparaison de modèles locaux
Bon ajustement : utilisateurs comparant les tailles de fichiers, quantifications et paramètres d'échantillonnage. Mode de défaillance : changer plusieurs contrôles à la fois et tirer des conclusions d'un seul prompt.
Commodité hébergée
Bon ajustement : utilisateurs avec matériel limité ou besoins multi-appareils. Mode de défaillance : se fier à une phrase courte de confidentialité de la FAQ sans lire les divulgations du fournisseur et de la publicité.[1][2]
Idéation d'images et de voix
Bon ajustement : expériences créatives à faible risque après vérification des crédits actuels. Mode de défaillance : téléverser du matériel privé, protégé par le droit d'auteur ou identifiable sans comprendre la route en ligne.
Support de décision professionnel
Mauvais ajustement : décisions médicales, légales, financières, de sécurité ou d'urgence. La confiance générée n'est pas une preuve, et l'exécution locale n'améliore pas la responsabilité factuelle.
LECTURE DE LA CONFIDENTIALITÉ
Comment interpréter les affirmations de confidentialité de Hammer AI ?
Utilisez une interprétation en couches. Premièrement, un modèle local sur bureau vérifié peut garder l'inférence sur l'ordinateur et continuer sans connexion réseau. Deuxièmement, le produit plus large a toujours des comptes, des diagnostics, des abonnements, de l'infrastructure et des services en ligne. Troisièmement, la politique de confidentialité dit que les fournisseurs IA externes peuvent traiter et conserver les prompts et sorties hébergés, tandis que certains services web ou mobiles gratuits peuvent envoyer du contenu récent pour la publicité contextuelle. La déclaration défendable est que Hammer AI offre une route locale, pas que chaque fonctionnalité de est hors ligne ou sans fournisseur.[1][2] Hammer AI
Pour un travail sensible, enregistrez le client exact, le modèle sélectionné, l'état de connexion, l'état du réseau et la fonctionnalité activée. Évitez les images cloud, la parole ou la synchronisation à moins que leur politique actuelle ne soit acceptable. Le stockage sur l'appareil et l'inférence locale sont des propriétés différentes et doivent être testés séparément.
VERDICT
Quand Hammer AI a-t-il un sens technique ?
Hammer AI a du sens lorsqu'un utilisateur veut une interface unique pour le chat de modèles locaux et les flux de travail de personnages structurés sans construire un front-end personnalisé. Sa valeur est l'intégration pratique : sélection de modèle, prompts de personnage, lore, histoires, outils médias et préférences dans un seul produit. Le coût de cette largeur est l'ambiguïté. La frontière de confidentialité change selon le mode, l'expérience locale change avec le matériel, et les catalogues ou allocations en ligne peuvent changer sans rendre une ancienne capture d'écran fausse.
Choisissez-le pour des expériences que vous pouvez vérifier et des sorties que vous examinerez. Ne le choisissez pas en supposant que chaque fonctionnalité est locale, qu'un modèle plus grand est toujours meilleur, ou que les détails du plan publié resteront fixes. Les Conditions officielles restreignent l'utilisation aux adultes et placent la responsabilité de l'utilisation légale et du contenu généré sur l'utilisateur.[5]
Explorer un service de personnages IAFAQ
Quelles questions techniques devriez-vous poser avant d'utiliser Hammer AI ?
Hammer AI peut-il fonctionner entièrement hors ligne ?
Le chat local sur bureau peut fonctionner hors ligne après installation et téléchargement du modèle. Les modèles hébergés, la synchronisation, la génération d'images et la parole doivent être supposés nécessiter une connexion à moins que l'interface actuelle ne le prouve explicitement.[1]
De combien de mémoire un modèle a-t-il besoin ?
Le fichier du modèle doit tenir dans la RAM ou VRAM disponible avec de l'espace supplémentaire pour le contexte et l'application. La quantification réduit les exigences de fichier et de mémoire, mais une compression plus forte peut réduire la qualité de sortie.[3]
Un modèle local rend-il la sortie fiable ?
Non. Local décrit où l'inférence se produit, pas si la réponse est précise, impartiale ou sûre. Appliquez les mêmes normes de vérification à la sortie locale et hébergée.
Les fournisseurs de Hammer AI peuvent-ils s'entraîner sur les chats cloud ?
La politique de confidentialité dit que les fournisseurs IA tiers peuvent conserver les entrées et sorties et peuvent les utiliser pour améliorer ou entraîner leurs modèles selon leurs propres politiques. Vérifiez les conditions du fournisseur nommé affichées dans le service actuel.[2]
Les prix capturés sont-ils toujours valides ?
Pas nécessairement. Les captures d'écran conservées prouvent ce que la page affichait lors de la capture. La page de tarification en direct est la source pour les abonnements actuels, les crédits, les limites de contexte et l'accès aux modèles.[4]
Hammer AI est-il destiné aux mineurs ?
Non. Les Conditions officielles disent que les utilisateurs doivent avoir au moins 18 ans ou l'âge du consentement dans leur juridiction, selon le plus élevé.[5]
SOURCES
Quelles sources officielles soutiennent ce guide de terrain ?
- [1] FAQ Hammer AI — descriptions de routes, test hors ligne et déclarations de compte.
- [2] Politique de confidentialité Hammer AI — fournisseurs hébergés, publicité contextuelle, comptes et diagnostics.
- [3] Guide des modèles et quantifications Hammer AI — mémoire, taille de fichier et compromis de compression.
- [4] Page de tarification Hammer AI — plans actuels, allocations et présentation des crédits.
- [5] Conditions de Hammer AI — éligibilité adulte, responsabilité de l'utilisateur et conditions de service.
Date d'observation : 19 octobre 2026. Les captures d'écran du produit, les catalogues de modèles, le langage de confidentialité et les limites commerciales peuvent changer. Les pages officielles actuelles prévalent sur les captures conservées.